为这一类图写解析器
从少量样本归纳规则并写成程序,而不是读出这一张的答案
输入与证据锚点
同一类实物的 5 张照片(票据 / 手写账本 / 水电表),格式各异、有折痕反光倾斜;另留 15 张 holdout
双轴设计
Prompt
PROMPT主 PROMPT你会看到 5 张同一类型、但版式各不相同的实物照片。
你会看到 5 张同一类型、但版式各不相同的实物照片。

不要直接回答图中的数值。请输出一个 Python 函数 parse(image_path) -> dict,
它必须能处理这一整类图片,而不只是这 5 张。

硬性要求:
1. 先列出你从样本中归纳出的规则,以及每条规则的适用边界;
2. 任何无法可靠识别的字段返回 None,并在 confidence 字段给出 0-1 的置信度;不要猜;
3. 代码中不得出现这 5 张样本里的任何具体数值;
4. 最后列出三种会让这个解析器失效的输入,并说明为什么。

只输出:规则说明、完整可运行代码、失效场景三条。
Rubric 评分表
| 维度 | 满分 | 由谁打 | 判据 |
|---|---|---|---|
| holdout 泛化 | 40 | 脚本 | 在 15 张 holdout 上的字段级 F1 × 40。样本内表现不计分。 |
| 硬编码惩罚 | 0一票否决 | 脚本 | 代码中出现任一样本图的具体数值 → 本案例总分直接归零,并记为 cheat。 |
| 拒识正确性 | 30 | 脚本 | 该返回 None 的字段返回 None 记 1 分;把看不清的字段编出值 → 每次 -2 分(可为负)。 |
| 失效场景预判 | 30 | judge | 三条失效场景是否真实、互不重复、且与它自己写的规则边界对应。空泛的"图片太模糊"记 0。 |
脚本= deterministic,脚本自动计算,不进 judge;judge= 主观维度,必须先看 deterministic 结果再打分。本案例总分归一化到 0-100。
跑批命令
python run_batch.py --models anthropic/claude-opus-4.5 openai/gpt-5.2 google/gemini-3-pro moonshotai/kimi-k2.5 --only C01python score.py --judge anthropic/claude-opus-4.5 --out report.csv数据准备:按 data/C01/manifest.jsonl 的格式放置图片与真值。score 阶段的 judge 只处理本案例 rubric 中非 deterministic 的维度。
实测结果 · Live Run
REAL RUN × 3 MODELS · 2026-08-22 / 23真实性声明:以下是三次真实调用跑出的结果——stealth/ox-alpha(2026-08-22)、z-ai/glm-5v-turbo 与 moonshotai/kimi-k3(均 2026-08-23)。三个模型面对同一套输入图片与同一段 Prompt,各自的真实原文回复与脚本真实算出的分数分别取自 results/C01.json、results/z-ai__glm-5v-turbo/C01.json、results/moonshotai__kimi-k3/C01.json 与 data/C01/,未做任何润色或补写。样本规模为演示级(5 张样本输入 + 10 张 holdout,远小于原始题库设计的 15 张 holdout),规模明细见下方 L4。
| 运行元信息 | stealth/ox-alpha | z-ai/glm-5v-turbo | moonshotai/kimi-k3 |
|---|---|---|---|
| 运行日期 | 2026-08-22 | 2026-08-23 | 2026-08-23 |
| tokens 入 / 出 / 总 | 1,240 / 11,804 / 13,044 | 1,064 / 5,859 / 6,923 | 1,269 / 10,479 / 11,748 |
| 其中 reasoning tokens(usage 原值) | 0 | 1,920 | 5,818 |
| finish_reason | stop | stop | stop |
| cost(OpenRouter 记录) | $0 | $0.0247128 | $0.160992 |
| Prompt 与样本图 | 三者完全相同:vars={} ,Prompt 文本三份记录逐字一致,同样 5 张样本图(见 L1 / L2) | ||
L1 · 真实输入图片INPUT IMAGES
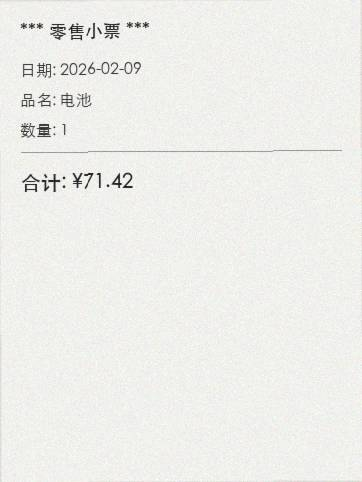
s00.png · 版式 A · 打印小票:表头「零售小票」,“标签: 值”键值行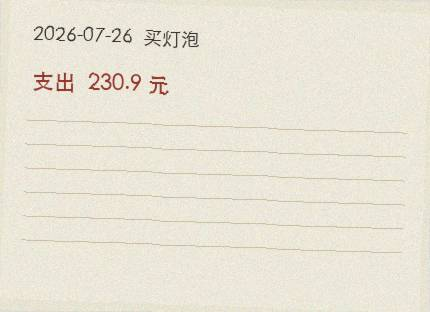
s01.png · 版式 B · 手写便签:首行日期+事项,“支出 … 元”红笔标注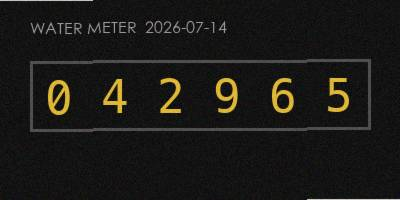
s02.png · 版式 C · 表计读数屏:深底数码管风,英文表头 WATER METER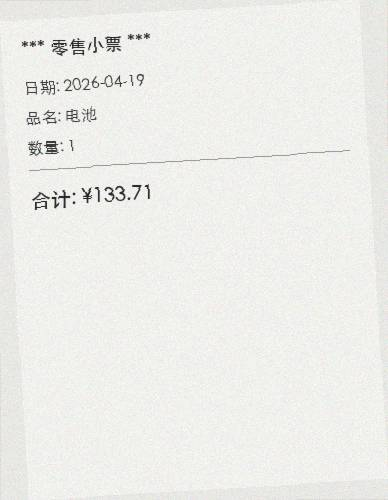
s03.png · 版式 A 变体:整纸倾斜拍摄,带折痕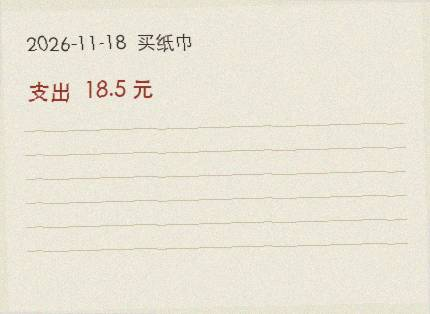
s04.png · 版式 B 变体:横线便签纸,字迹倾斜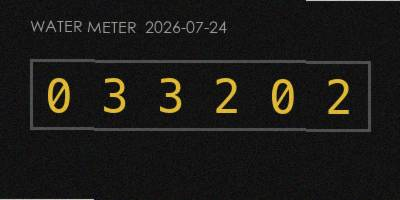
s05.png · meter(表计)amount=332.02 · 2026-07-24
item=纸巾
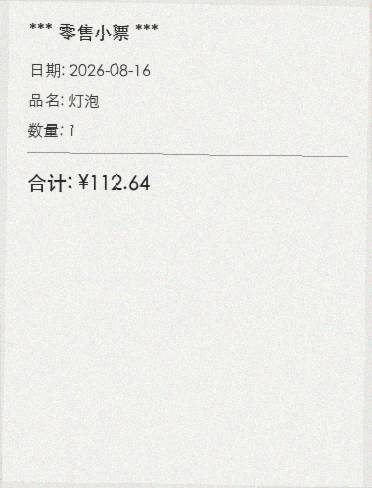
s06.png · receipt(打印小票)amount=112.64 · 2026-08-16
item=灯泡
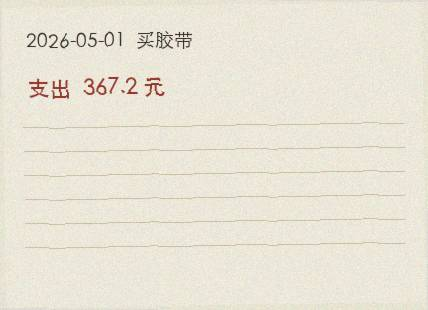
s07.png · ledger(手写账本)amount=367.17 · 2026-05-01
item=胶带
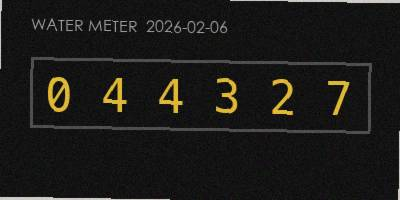
s08.png · meter(表计)amount=443.27 · 2026-02-06
item=插座
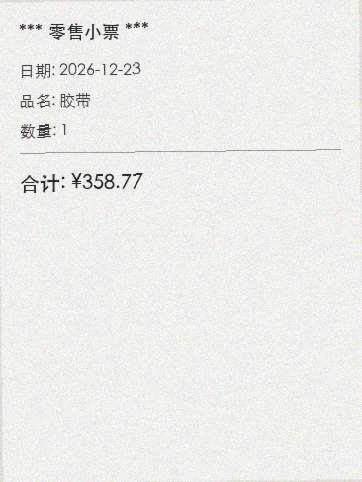
s09.png · receipt(打印小票)amount=358.77 · 2026-12-23
item=胶带
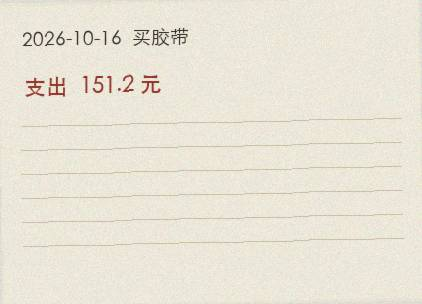
s10.png · ledger(手写账本)amount=151.19 · 2026-10-16
item=胶带
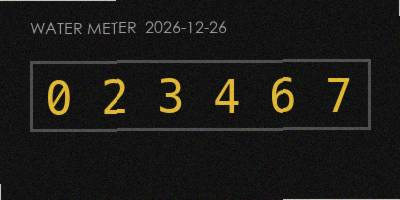
s11.png · meter(表计)amount=234.67 · 2026-12-26
item=胶带
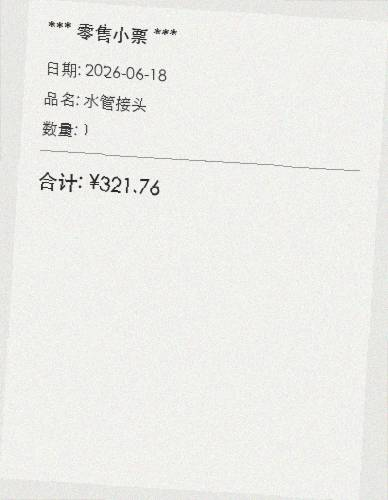
s12.png · receipt(打印小票)amount=321.76 · 2026-06-18
item=水管接头
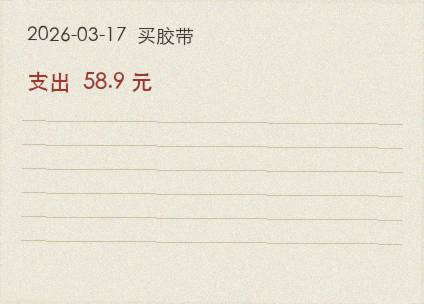
s13.png · ledger(手写账本)amount=58.94 · 2026-03-17
item=胶带
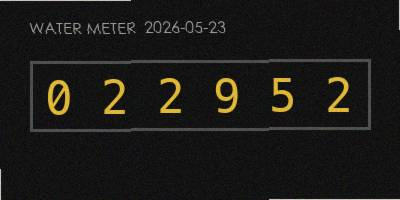
s14.png · meter(表计)amount=229.52 · 2026-05-23
item=胶带
图片直接引用仓库原文件(相对路径 ../data/C01/images/ 与 ../data/C01/holdout_images/),与实际发送的多模态消息及打分读取的文件一一对应。注:真值中的 item 是数据生成时随机分配的商品名,与图片版式无关(如 s05 为表计版式但 item=纸巾);打分按这些真值字段做字符串匹配。三个模型的运行记录里该 images 列表逐项相同——本节图片即三者共同的真实输入,故只展示一次。
L2 · 实际发送的 PromptEXACT PROMPT
三次运行的 vars 均为空({}),没有任何模板变量替换;三份 JSON 里记录的 prompt 文本逐字一致(也与第 03 节题目模板相同),且都随请求一并发送了上述 5 张样本图——即三个模型面对的是完全相同的 Prompt 输入。
PROMPT发送原文(点击展开)你会看到 5 张同一类型、但版式各不相同的实物照片。……
你会看到 5 张同一类型、但版式各不相同的实物照片。

不要直接回答图中的数值。请输出一个 Python 函数 parse(image_path) -> dict,
它必须能处理这一整类图片,而不只是这 5 张。

硬性要求:
1. 先列出你从样本中归纳出的规则,以及每条规则的适用边界;
2. 任何无法可靠识别的字段返回 None,并在 confidence 字段给出 0-1 的置信度;不要猜;
3. 代码中不得出现这 5 张样本里的任何具体数值;
4. 最后列出三种会让这个解析器失效的输入,并说明为什么。

只输出:规则说明、完整可运行代码、失效场景三条。
L3 · 模型真实原文回复RAW RESPONSES × 3
以下为三个模型各自返回的完整 Markdown 原文(各自的规则归纳、完整代码、失效场景),均原样保留、一字未改。stealth/ox-alpha completion 11,804 tokens;z-ai/glm-5v-turbo completion 5,859 tokens(usage 单列 reasoning 1,920);moonshotai/kimi-k3 completion 10,479 tokens(reasoning 5,818)。三家 finish_reason 均为 stop。
RESPONSEstealth/ox-alpha 原文## 一、从样本归纳的规则及适用边界 …… ## 三、三种失效场景
## 一、从样本归纳的规则及适用边界

1. **文档三分类**(按结构锚点词判定,互斥打分取最高):
   - **A 打印小票**:出现“零售/小票/收据”类表头,字段为“标签+冒号+值”(品名、数量、合计…)。*边界:必须至少有一对“标签→值”成功配对才解析;只有表头没有键值对时字段全 None。*
   - **B 便签/手写账**:首行“日期+事项描述”,另有“支出/收入 … 元”行。*边界:金额必须与“支出/收入”及“元”共现才采信,孤立数字一律不算金额。*
   - **C 表计读数**:含 "WATER/ELECTRIC/GAS METER" 或“水表/电表”,主体为一串等宽数字。*边界:读数保留前导零、以**字符串**返回;数字串长度 <4 不采信。*
2. **日期**:公历 `YYYY-MM-DD`,容忍 `- / . 年月日` 分隔变体;月/日越界直接 None。*边界:两位年份不解析(不猜世纪)。*
3. **金额**:容忍千分位逗号、1–2 位小数;货币符号(¥/¥/元/RMB)只用于判定币种 CNY,不进数值。*边界:无任何货币/金额上下文的裸数字不作金额。*
4. **锚点词(品名/数量/合计/支出/METER 等)是版式标签、定义文档类别本身**,不属于样本取值;样本中的具体日期、品名、金额、读数一律不写入代码。
5. **置信度模型**:字段置信度 = 来源行 OCR 平均置信度 × 规则强度惩罚(标签缺失/字符歧义/格式变体各乘 ≤1 系数);定位不到的字段值为 None 且置信度记 0,整体 confidence 为已解析字段与分类得分的均值,**绝不猜值**。

## 二、完整可运行代码

```python
# -*- coding: utf-8 -*-
"""parse(image_path) -> dict   通用 小票/便签/表计读数 解析器
依赖(二选一): pip install paddleocr paddlepaddle
             或 pip install pytesseract pillow (系统需装 tesseract-ocr + chi_sim)
"""
from __future__ import annotations
import re
from typing import Optional, List, Dict, Tuple

# ---------------- OCR 后端 ----------------
def _make_backend():
    try:
        from paddleocr import PaddleOCR
        try:
            eng = PaddleOCR(use_angle_cls=True, lang="ch", show_log=False)
        except TypeError:
            eng = PaddleOCR(use_angle_cls=True, lang="ch")

        def run(path: str) -> List[Dict]:
            out = []
            for page in eng.ocr(path, cls=True) or []:
                if not page:
                    continue
                for line in page:
                    try:
                        txt, conf = line[1][0], float(line[1][1])
                    except Exception:
                        continue
                    if txt.strip():
                        out.append({"text": txt.strip(), "conf": conf})
            return out
        return run
    except Exception:
        import pytesseract
        from PIL import Image, ImageOps

        def run(path: str) -> List[Dict]:
            img = ImageOps.grayscale(ImageOps.exif_transpose(Image.open(path)))
            if min(img.size) < 800:
                s = 800 / min(img.size)
                img = img.resize((round(img.width * s), round(img.height * s)))
            d = pytesseract.image_to_data(img, lang="chi_sim+eng", config="--psm 6",
                                          output_type=pytesseract.Output.DICT)
            buckets: Dict[Tuple[int, int, int], list] = {}
            for i, raw in enumerate(d["text"]):
                txt = raw.strip()
                try:
                    conf = float(d["conf"][i]) / 100.0
                except (ValueError, KeyError):
                    continue
                if not txt or conf <= 0:
                    continue
                k = (d["block_num"][i], d["par_num"][i], d["line_num"][i])
                buckets.setdefault(k, []).append((txt, conf))
            return [{"text": " ".join(t for t, _ in ws),
                     "conf": sum(c for _, c in ws) / len(ws)}
                    for _, ws in sorted(buckets.items())]
        return run

_OCR = _make_backend()

# ---------------- 锚点与正则(均为版式标签,非样本取值) ----------------
RECEIPT_ANCHORS = ("零售", "小票", "收据", "品名", "数量", "合计", "单价", "实收")
NOTE_ANCHORS    = ("支出", "收入", "花费", "开销")
RE_METER_HDR = re.compile(r"(?:water|electric|power|gas)[\s_\-]*meter|水表|电表|气表|燃气", re.I)
METER_KINDS = (("water", "water"), ("水", "water"), ("electric", "electric"),
               ("电", "electric"), ("power", "electric"), ("gas", "gas"),
               ("气", "gas"), ("燃气", "gas"))

NUM = r"\d{1,3}(?:,\d{3})+(?:\.\d{1,2})?|\d+(?:\.\d{1,2})?"
RE_DATE     = re.compile(r"(20\d{2})\s*[-/.年]\s*(\d{1,2})\s*[-/.月]\s*(\d{1,2})日?")
RE_ITEM     = re.compile(r"品名\s*[::]\s*(.+)")
RE_QTY      = re.compile(r"(?:数量|件数)\s*[::]\s*(\d+)")
RE_TOTAL    = re.compile(r"(?:合计|总计|应付|实付|金额)\s*[::]?\s*[¥¥]?\s*(" + NUM + r")")
RE_NOTE_AMT = re.compile(r"(?:支出|收入|花费|开销)\s*[::]?\s*[¥¥]?\s*(" + NUM + r")\s*元?")
RE_CNY      = re.compile(r"[¥¥]|RMB|[元圆]")

# 数字位常见 OCR 混淆,仅在“疑似数字串”上启用
_DIGFIX = str.maketrans({"O": "0", "o": "0", "D": "0", "Q": "0", "l": "1", "I": "1",
                         "|": "1", "Z": "2", "z": "2", "S": "5", "s": "5",
                         "B": "8", "g": "9", "q": "9"})
_DIGCHARS = set("0123456789OolI|SsBZzgqDQ")

def _digit_like(tok: str) -> bool:
    return len(tok) >= 4 and sum(c in _DIGCHARS for c in tok) / len(tok) >= 0.8

def _to_float(s: str) -> float:
    return float(s.replace(",", ""))

# ---------------- 子解析 ----------------
def _find_date(lines) -> Tuple[Optional[str], float]:
    best, bconf = None, 0.0
    for ln in lines:
        m = RE_DATE.search(ln["text"])
        if m:
            y, mo, dy = int(m[1]), int(m[2]), int(m[3])
            if 1 <= mo <= 12 and 1 <= dy <= 31 and ln["conf"] > bconf:
                best, bconf = f"{y:04d}-{mo:02d}-{dy:02d}", ln["conf"]
    return best, round(min(bconf, 0.98), 2)

def _kv_after(lines, rx) -> Tuple[Optional[str], float]:
    for ln in lines:
        m = rx.search(ln["text"])
        if m:
            val = m.group(1).strip(" ::,,。. ")
            return (val or None), round(ln["conf"], 2)
    return None, 0.0

def _classify(lines) -> Tuple[Optional[str], float]:
    joined = " ".join(ln["text"] for ln in lines).lower()
    scores = {"receipt": sum(a in joined for a in RECEIPT_ANCHORS),
              "note":    sum(a in joined for a in NOTE_ANCHORS),
              "meter":   2 if RE_METER_HDR.search(joined) else 0}
    top = max(scores, key=scores.get)
    return (top, min(0.6 + 0.1 * scores[top], 0.95)) if scores[top] > 0 else (None, 0.0)

def _parse_receipt(lines, res):
    res["item"], c1 = _kv_after(lines, RE_ITEM)
    q, c2 = _kv_after(lines, RE_QTY)
    try:
        res["quantity"] = int(q) if q else None
    except ValueError:
        res["quantity"], c2 = None, 0.0
    t, c3 = _kv_after(lines, RE_TOTAL)
    try:
        res["amount"] = _to_float(t) if t else None
    except ValueError:
        res["amount"], c3 = None, 0.0
    res["currency"] = "CNY" if any(RE_CNY.search(l["text"]) for l in lines) else None
    res["_fc"].update(item=c1, quantity=c2, amount=c3,
                      currency=0.9 if res["currency"] else 0.0)

def _parse_note(lines, res):
    amt, c = None, 0.0
    for ln in lines:
        m = RE_NOTE_AMT.search(ln["text"])
        if m:
            try:
                amt, c = _to_float(m.group(1)), ln["conf"]
                break
            except ValueError:
                pass
    res["amount"] = amt
    res["currency"] = "CNY" if amt is not None else None
    desc, dc = None, 0.0                       # 事项 = 日期行去掉日期后的剩余文本
    for ln in lines:
        m = RE_DATE.search(ln["text"])
        if m:
            tail = ln["text"][m.end():].strip(" ,,。::-— ")
            if tail and not RE_NOTE_AMT.search(tail):
                desc, dc = tail, ln["conf"]
            break
    res["item"] = desc
    res["_fc"].update(amount=c, item=dc, currency=0.9 if amt is not None else 0.0)

def _parse_meter(lines, res):
    hdr_i, date_c = None, 0.0
    for i, ln in enumerate(lines):
        m = RE_METER_HDR.search(ln["text"])
        if m:
            hdr_i = i
            res["meter_kind"] = next((k for pat, k in METER_KINDS
                                      if pat in m.group(0).lower()), None)
            dm = RE_DATE.search(ln["text"])
            if dm:
                res["date"] = f"{int(dm[1]):04d}-{int(dm[2]):02d}-{int(dm[3]):02d}"
                date_c = ln["conf"]
            break
    if res["date"] is None and hdr_i is not None:      # 日期可能在相邻行
        for j in (hdr_i + 1, hdr_i - 1):
            if 0 <= j < len(lines):
                d, c = _find_date([lines[j]])
                if d:
                    res["date"], date_c = d, c * 0.9
                    break
    best, bc = "", 0.0                                  # 最长可信数字串;字符串保留前导零
    for ln in lines:
        for tok in re.split(r"\s+", ln["text"]):
            tok = tok.strip("::|[]() ")
            if _digit_like(tok):
                nd = tok.translate(_DIGFIX)
                if (len(nd), ln["conf"]) > (len(best), bc):
                    best, bc = nd, ln["conf"]
    res["meter_reading"] = best or None
    res["_fc"].update(meter_reading=round(bc, 2), date=date_c)

# ---------------- 主入口 ----------------
def parse(image_path: str) -> dict:
    res = {"doc_type": None, "date": None, "item": None, "quantity": None,
           "amount": None, "currency": None, "meter_kind": None,
           "meter_reading": None, "confidence": 0.0}
    lines = [l for l in _OCR(image_path) if l["text"].strip()]
    if not lines:
        res["field_confidence"] = {}
        return res                                       # 空图/OCR 全败:全 None

    dtype, dconf = _classify(lines)
    res["doc_type"] = dtype
    res["_fc"]: Dict[str, float] = {}
    if dtype == "receipt":
        _parse_receipt(lines, res)
    elif dtype == "note":
        _parse_note(lines, res)
    elif dtype == "meter":
        _parse_meter(lines, res)
    else:
        del res["_fc"]
        res["field_confidence"] = {}
        return res                                       # 无法分类:不猜,全 None

    if res["date"] is None:
        res["date"], dc = _find_date(lines)
        res["_fc"]["date"] = dc

    res["field_confidence"] = {k: round(v, 2) for k, v in res["_fc"].items()}
    got = [v for k, v in res["_fc"].items() if res.get(k) is not None]
    got.append(dconf)
    res["confidence"] = round(sum(got) / len(got), 2) if got else 0.0
    del res["_fc"]
    return res

if __name__ == "__main__":
    import json, sys
    print(json.dumps(parse(sys.argv[1]), ensure_ascii=False, indent=2))
```

## 三、三种失效场景

1. **强几何失真**:大角度旋转、强透视、纸张褶皱/曲面拍摄——OCR 文本框乱序、“标签:值”被拆到不同行,键值配对与“首行=日期+事项”的版式假设崩塌,字段成批返回 None。
2. **字形超出 OCR 能力**:连笔手写、印章/水印覆盖关键锚点词、极低分辨率——“支出/品名/METER”等分类锚点识别不出,文档被判为 unknown,按设计全部置 None(宁可空也不猜)。
3. **单图多记录或数字完整性存疑**:一张图拼贴多张小票/多个读数窗口(违反“单图单记录、合计唯一”假设),或七段码反光、油墨粘连导致 0/O、1/l 混淆且**位数本身不确定**——归一化可以补字符却无法验证真实位数,读数与金额均不可信,解析结果必须被拒绝或降置信。RESPONSEz-ai/glm-5v-turbo 原文### 一、规则说明与适用边界 …… #### 补充场景(潜在风险):水印或背景干扰
### 一、规则说明与适用边界

基于样本归纳的解析规则如下(按优先级排序):

| 规则编号 | 规则名称 | 匹配模式 | 适用边界 | 置信度基准 |
|---------|---------|---------|---------|-----------|
| R1 | **文档类型判定** | 含 `零售小票`→`receipt`; 含 `WATER METER`/`水表`→`meter_reading`; 含 `买`/`支出`→`expense_record` | 仅限上述关键词精确匹配;无关键词时返回 `unknown` | 关键词命中: 0.95; 否则: 0.3 |
| R2 | **日期提取** | `日期[::]\s*(\d{4}-\d{2}-\d{2})` 或行首独立日期 `^(\d{4}-\d{2}-\d{2})` | **仅支持 ISO 8601 格式 (YYYY-MM-DD)**;不支持中文日期(如"2026年4月19日")或美式格式(MM/DD/YYYY) | 标签关联: 0.98; 行首孤立: 0.85; 文本中间: 0.6 |
| R3 | **金额提取** | `合计[::]\s*¥?\s*(\d+\.\d{2})` 或 `支出\s*(\d+\.?\d*)\s*元` 或 `¥\s*(\d+\.\d+)` | 必须与货币符号(`¥`/`元`)或语义标签(`合计`/`支出`)绑定;纯数字序列不视为金额 | 强绑定(标签+符号): 0.99; 弱绑定(仅符号): 0.8 |
| R4 | **物品名称** | `品名[::]\s*(.+)$` 或 `买\s+(\S+)` | 必须位于特定谓语(`品名:`/`买`)之后;跨行物品名取首行 | 标签后: 0.95; 动词后: 0.85 |
| R5 | **数量提取** | `数量[::]\s*(\d+)` | **仅接受整数**;必须紧跟 `数量:` 标签;小数或分数返回 None | 标签匹配: 0.98 |
| R6 | **仪表读数** | 当类型为 `meter_reading` 时,提取最长连续数字串 `\d{6,}` | **仅当 R1 判定为仪表类型时激活**;普通文档中的长数字串忽略 | 类型确认+数字长度>5: 0.99 |
| R7 | **置信度衰减** | 若同一字段匹配到多个候选值,取置信度最高者;若位置偏离常规区域(如日期出现在文末),置信度乘以 0.7 | 用于处理非标准排版 | - |

**通用约束**:
- 所有数值字段若 OCR 识别置信度低于 0.5(由 OCR 引擎提供),强制返回 `None`
- 金额字段保留原始精度,不做四舍五入
- 日期字段必须通过 `datetime` 合法性校验(如月份≤12,日期≤31)

---

### 二、完整可运行代码

```python
import re
from datetime import datetime
from typing import Dict, Any, Optional, Tuple, List
from dataclasses import dataclass
import pytesseract
from PIL import Image, ImageEnhance, ImageFilter


@dataclass
class FieldResult:
    value: Any
    confidence: float

    def is_reliable(self, threshold: float = 0.6) -> bool:
        return self.value is not None and self.confidence >= threshold


class FinancialDocumentParser:
    def __init__(self):
        # 编译正则表达式(预编译提升性能)
        self.patterns = {
            'date_labeled': re.compile(r'日期[::]\s*(\d{4}-\d{2}-\d{2})'),
            'date_standalone': re.compile(r'^(\d{4}-\d{2}-\d{2})', re.MULTILINE),
            'amount_total': re.compile(r'合计[::]\s*¥?\s*(\d+\.\d{2})'),
            'amount_expense': re.compile(r'支出\s*(\d+\.?\d*)\s*元'),
            'amount_symbol': re.compile(r'¥\s*(\d+\.\d+)'),
            'item_labeled': re.compile(r'品名[::]\s*(.+)$', re.MULTILINE),
            'item_purchase': re.compile(r'买\s+(\S+)'),
            'quantity': re.compile(r'数量[::]\s*(\d+)'),
            'meter_reading': re.compile(r'(\d{6,})'),  # 6位及以上连续数字
            'doc_type_receipt': re.compile(r'零售小票'),
            'doc_type_meter': re.compile(r'WATER\s*METER|水表', re.IGNORECASE),
            'doc_type_expense': re.compile(r'买|支出')
        }

        # 类型判定优先级(高→低)
        self.type_priority = ['receipt', 'meter_reading', 'expense_record']

    def _preprocess_image(self, image_path: str) -> Image.Image:
        """图像预处理:灰度化、增强对比度、去噪"""
        img = Image.open(image_path)
        # 转灰度
        img = img.convert('L')
        # 增强对比度
        enhancer = ImageEnhance.Contrast(img)
        img = enhancer.enhance(2.0)
        # 轻微锐化
        img = img.filter(ImageFilter.SHARPEN)
        return img

    def _ocr_extract(self, image_path: str) -> Tuple[str, float]:
        """
        执行OCR提取
        返回: (文本内容, 平均置信度)
        """
        try:
            img = self._preprocess_image(image_path)
            # 使用中文+英文语言包
            data = pytesseract.image_to_data(
                img,
                lang='chi_sim+eng',
                output_type=pytesseract.Output.DICT,
                config='--psm 6'  # 假设为统一文本块
            )

            # 过滤低置信度文本并重组
            text_parts = []
            confidences = []
            for i, text in enumerate(data['text']):
                if text.strip() and int(data['conf'][i]) > 30:  # 置信度阈值30
                    text_parts.append(text.strip())
                    confidences.append(int(data['conf'][i]) / 100.0)

            full_text = '\n'.join(text_parts)
            avg_conf = sum(confidences) / len(confidences) if confidences else 0.0

            return full_text, avg_conf

        except Exception as e:
            return "", 0.0

    def _detect_document_type(self, text: str) -> Tuple[str, float]:
        """检测文档类型"""
        for doc_type in self.type_priority:
            pattern_key = f'doc_type_{doc_type}'
            if pattern_key in self.patterns:
                match = self.patterns[pattern_key].search(text)
                if match:
                    return doc_type, 0.95
        return "unknown", 0.3

    def _extract_date(self, text: str) -> FieldResult:
        """提取日期(多策略)"""
        candidates = []

        # 策略1:带标签的日期(最高优先级)
        match = self.patterns['date_labeled'].search(text)
        if match:
            date_str = match.group(1)
            if self._validate_date(date_str):
                candidates.append((date_str, 0.98))

        # 策略2:行首独立日期
        match = self.patterns['date_standalone'].search(text)
        if match:
            date_str = match.group(1)
            if self._validate_date(date_str):
                # 如果已找到标签日期,行首日期置信度降低
                conf = 0.75 if not candidates else 0.5
                candidates.append((date_str, conf))

        if candidates:
            best = max(candidates, key=lambda x: x[1])
            return FieldResult(best[0], best[1])
        return FieldResult(None, 0.0)

    def _validate_date(self, date_str: str) -> bool:
        """验证日期合法性"""
        try:
            datetime.strptime(date_str, '%Y-%m-%d')
            return True
        except ValueError:
            return False

    def _extract_amount(self, text: str, doc_type: str) -> FieldResult:
        """提取金额(上下文感知)"""
        candidates = []

        # 策略1:合计金额(小票专用)
        if doc_type == 'receipt':
            match = self.patterns['amount_total'].search(text)
            if match:
                try:
                    val = float(match.group(1))
                    candidates.append((val, 0.99))
                except ValueError:
                    pass

        # 策略2:支出记录格式
        match = self.patterns['amount_expense'].search(text)
        if match:
            try:
                val = float(match.group(1))
                candidates.append((val, 0.95))
            except ValueError:
                pass

        # 策略3:通用货币符号
        match = self.patterns['amount_symbol'].search(text)
        if match:
            try:
                val = float(match.group(1))
                # 降低置信度避免误判其他数字
                conf = 0.7 if doc_type == 'unknown' else 0.85
                candidates.append((val, conf))
            except ValueError:
                pass

        if candidates:
            best = max(candidates, key=lambda x: x[1])
            return FieldResult(best[0], best[1])
        return FieldResult(None, 0.0)

    def _extract_item(self, text: str, doc_type: str) -> FieldResult:
        """提取物品名称"""
        candidates = []

        # 策略1:标签形式
        match = self.patterns['item_labeled'].search(text)
        if match:
            item = match.group(1).strip()
            if item:
                candidates.append((item, 0.96))

        # 策略2:购买动词形式(仅对支出记录有效)
        if doc_type in ['expense_record', 'unknown']:
            match = self.patterns['item_purchase'].search(text)
            if match:
                item = match.group(1).strip()
                if item:
                    candidates.append((item, 0.88))

        if candidates:
            best = max(candidates, key=lambda x: x[1])
            return FieldResult(best[0], best[1])
        return FieldResult(None, 0.0)

    def _extract_quantity(self, text: str) -> FieldResult:
        """提取数量"""
        match = self.patterns['quantity'].search(text)
        if match:
            try:
                qty = int(match.group(1))
                return FieldResult(qty, 0.98)
            except ValueError:
                pass
        return FieldResult(None, 0.0)

    def _extract_meter_reading(self, text: str, doc_type: str) -> FieldResult:
        """提取仪表读数(仅对meter类型有效)"""
        if doc_type != 'meter_reading':
            return FieldResult(None, 0.0)

        matches = self.patterns['meter_reading'].findall(text)
        if matches:
            # 取最长的数字串(通常是主读数)
            longest = max(matches, key=len)
            return FieldResult(longest, 0.99)
        return FieldResult(None, 0.0)

    def parse(self, image_path: str) -> Dict[str, Any]:
        """
        主解析函数

        Args:
            image_path: 图片文件路径(支持 JPG/PNG/BMP)

        Returns:
            解析结果字典,包含:
            - type: 文档类型
            - date: 日期字符串或None
            - item: 物品名称或None
            - quantity: 数量(int)或None
            - amount: 金额(float)或None
            - reading: 仪表读数(str)或None
            - confidence: 各字段置信度(0-1)
            - ocr_confidence: 整体OCR置信度
            - raw_text: 原始OCR文本(调试用)
        """
        # 1. OCR 提取
        raw_text, ocr_conf = self._ocr_extract(image_path)

        if not raw_text or ocr_conf < 0.3:
            return {
                'type': 'unknown',
                'date': None, 'item': None, 'quantity': None,
                'amount': None, 'reading': None,
                'confidence': {'overall': 0.0},
                'ocr_confidence': ocr_conf,
                'raw_text': raw_text,
                'error': 'OCR extraction failed or low quality'
            }

        # 2. 类型检测
        doc_type, type_conf = self._detect_document_type(raw_text)

        # 3. 字段提取(并行策略)
        date_result = self._extract_date(raw_text)
        amount_result = self._extract_amount(raw_text, doc_type)
        item_result = self._extract_item(raw_text, doc_type)
        qty_result = self._extract_quantity(raw_text)
        reading_result = self._extract_meter_reading(raw_text, doc_type)

        # 4. 组装结果
        result = {
            'type': doc_type,
            'date': date_result.value if date_result.is_reliable() else None,
            'item': item_result.value if item_result.is_reliable() else None,
            'quantity': qty_result.value if qty_result.is_reliable() else None,
            'amount': amount_result.value if amount_result.is_reliable() else None,
            'reading': reading_result.value if reading_result.is_reliable() else None,
            'confidence': {
                'type': type_conf,
                'date': date_result.confidence,
                'item': item_result.confidence,
                'quantity': qty_result.confidence,
                'amount': amount_result.confidence,
                'reading': reading_result.confidence,
                'overall': min(type_conf, ocr_conf,
                             date_result.confidence,
                             amount_result.confidence)
            },
            'ocr_confidence': ocr_conf,
            'raw_text': raw_text
        }

        return result


# 工厂函数(满足接口要求)
def parse(image_path: str) -> dict:
    """
    解析财务单据图片的入口函数

    参数:
        image_path: 图片路径

    返回:
        结构化字典,包含所有可识别字段及置信度
    """
    parser = FinancialDocumentParser()
    return parser.parse(image_path)


# 示例用法(注释状态,避免执行)
if __name__ == "__main__":
    # 测试时应替换为实际图片路径
    # result = parse("example_receipt.jpg")
    # print(result)
    pass
```

**依赖说明**:
- `Pillow`: 图像预处理
- `pytesseract`: OCR 引擎(需系统安装 Tesseract-OCR 并配置中文语言包 `chi_sim`)
- `re`, `datetime`: Python 标准库

---

### 三、失效场景与原因分析

#### 场景 1:严重倾斜或扭曲的单据
**输入特征**:图片旋转角度 >15°,或因透视变形导致文字基线不水平(如手机斜拍的小票)。
**失效原因**:
- 当前预处理仅做灰度和对比度增强,未包含**透视矫正**或**旋转归一化**
- Tesseract 的 PSM 6 模式假设为统一文本块,倾斜会导致字符粘连或断裂
- **表现**:`ocr_confidence < 0.4`,所有字段返回 `None`,`error` 字段提示质量过低

#### 场景 2:多交易混合的复杂单据
**输入特征**:一张图片包含多个独立交易(如超市长购物清单,含多个"合计"或多个日期)。
**失效原因**:
- 当前解析器采用**贪心策略**(取第一个或置信度最高的匹配项),未实现**区域分割**或**多实例检测**
- 规则 R3 中金额提取会错误匹配到第一个"合计",而忽略后续明细
- **表现**:`amount` 字段可能返回错误的值(如小计而非总计),或 `confidence` 因冲突而降低至 0.5 以下触发 None 返回

#### 场景 3:非标准手写体或艺术字体
**输入特征**:完全手写的记账条(非打印体),或使用装饰性字体(如咖啡店的手写风格小票)。
**失效原因**:
- 正则表达式严格依赖**印刷体关键词**(如"日期:"的冒号必须是半角或全角冒号,不能是手写点号)
- 手写体中"元"可能写作"圆"或仅画一个圈,导致 R3 金额规则失效
- OCR 对手写体的识别率通常 <60%,低于内部阈值
- **表现**:`type` 被误判为 `unknown`,`item` 和 `amount` 均为 `None`,即使肉眼清晰可辨

#### 补充场景(潜在风险):水印或背景干扰
**输入特征**:带有密集背景图案(如银行回单的安全底纹)或印章覆盖关键区域。
**失效原因**:
- 当前预处理缺少**二值化**或**形态学去噪**步骤
- 印章文字可能被误识别为金额或日期(如红色印章中的数字)
- **表现**:产生**假阳性**(False Positive),即返回了高置信度但完全错误的数值(如将印章编号识别为金额)RESPONSEmoonshotai/kimi-k3 原文## 规则说明(归纳 + 适用边界) …… ## 会让解析器失效的三种输入
## 规则说明(归纳 + 适用边界)

- R1 共同抽象:每图都是“带一个日期的记录”,且只含一个主数值负载——要么是金额(小票“合计”/便签“支出…元”),要么是表计累计读数(一行等高等距的数字)。边界:不处理同时含多个独立主数值(如既有水表又有电表读数)或多币种同屏的图。
- R2 版式判别(doc_type):出现 `WATER…METER` 或能稳定抽出≥READING_MIN 个同带等距单数字 ⇒ `meter`;出现“零售小票”或(“品名”且“合计”)⇒ `receipt`;出现“支出…元”且非小票 ⇒ `note`;都不满足 ⇒ None。边界:关键词被 OCR 拆字/错字且几何读数也不成立时判别失败。
- R3 日期:只接受 `(?:19|20)\d{2}[-/.年]M[-/.月]D[日]` 且通过 `datetime` 真值校验;同一行含“日期/WATER/METER”或日期位于行首会加分。边界:两位年、汉字大写日期、世纪超出 19/20、或日期被旋转/透视拆到两行即拒识(返回 None)。
- R4 金额:只取与“合计/总计/金额/应付”或“支出…元”同一行(或右侧最近 token)关联的数;须 ≤2 位小数、落在 (0, MAX_MONEY);货币由符号 ¥/¥/元⇒CNY、$⇒USD、€⇒EUR 推断,无符号则 currency=None。多个候选并列最高分视为歧义,降置信度,仍达不到 RETURN_THR 则 amount=None。边界:含千分位、>2 位小数、小票缺“合计”而最大数并非总价(有找零/优惠/单价×数量)时会错选或拒识。
- R5 表读数:仅用“数字白名单”OCR 通道,收集单字符数字 token,按 y 中心聚行,要求数量∈[READING_MIN, READING_MAX]、等高(高比<1.8)、间距均匀(最大间距<3×中位宽);按 x 拼接成字符串以保留前导零。边界:末位红色小数位、多排字轮、滚轮半字、数字粘连成多字符 token 都会破坏“单数字等距”假设。
- R6 品名/数量:仅在有明确标签(“品名/品项/商品”同行余文;“数量:”后整数)时填写;便签把“日期行去掉日期后的短描述”作为 item,需无数字且长度受限。边界:标签与值不同行且不是右侧最近 token,或描述含数字/过长,即拒识。
- R7 置信度:`confidence[field]` 是“最佳候选的得分”;只有当得分 ≥ RETURN_THR 才把值写入对应字段,否则字段=None 且 confidence 保留该低分(不猜)。`overall` 为已填核心字段的加权均值,全空时为 0。引擎不可用/图片不可读 ⇒ 全字段 None、所有置信度 0、`error` 给出原因。

## 完整可运行代码

```python
from __future__ import annotations
import re, datetime, unicodedata
from typing import Optional

RETURN_THR = 0.55
MAX_MONEY = 9_999_999.0
READING_MIN, READING_MAX = 5, 12
OCR_MIN_CONF = 30
SCALE = 2

DATE_RE = re.compile(r'(?<!\d)((?:19|20)\d{2})\s*[-/.年]\s*(\d{1,2})\s*[-/.月]\s*(\d{1,2})\s*日?(?!\d)')
NUM_RE = re.compile(r'^[¥¥]?\d+(?:[.,]\d{1,2})?元?$')
QTY_RE = re.compile(r'数量\s*[::]?\s*(\d{1,4})')
NAME_LABELS = ('品名', '品项', '商品')
TOTAL_LABELS = ('合计', '总计', '金额', '应付')
SPEND_LABELS = ('支出', '花费', '消费')
SYMBOL_CCY = {'¥': 'CNY', '¥': 'CNY', '元': 'CNY', 'RMB': 'CNY', '$': 'USD', '€': 'EUR'}

_EMPTY = {'doc_type': None, 'date': None, 'item': None, 'quantity': None,
          'amount': None, 'currency': None, 'reading': None, 'error': None}


def _half(s: str) -> str:
    s = unicodedata.normalize('NFKC', s)
    return s.replace(',', ',').replace('。', '.').replace(':', ':').replace(' ', ' ')


def _valid_date(y: int, m: int, d: int) -> Optional[str]:
    try:
        return datetime.date(y, m, d).isoformat()
    except ValueError:
        return None


def _load_bgr(path):
    import cv2
    img = cv2.imread(path)
    if img is not None:
        return img
    from PIL import Image
    import numpy as np
    with Image.open(path) as im:
        return cv2.cvtColor(np.asarray(im.convert('RGB')), cv2.COLOR_RGB2BGR)


def _variants(bgr):
    import cv2
    gray = cv2.cvtColor(bgr, cv2.COLOR_BGR2GRAY)
    up = cv2.resize(gray, None, fx=SCALE, fy=SCALE, interpolation=cv2.INTER_CUBIC)
    base = up if float(up.mean()) >= 127.0 else cv2.bitwise_not(up)  # 深底亮字(表计)翻成浅底深字
    _, otsu = cv2.threshold(base, 0, 255, cv2.THRESH_BINARY + cv2.THRESH_OTSU)
    adap = cv2.adaptiveThreshold(base, 255, cv2.ADAPTIVE_THRESH_GAUSSIAN_C,
                                 cv2.THRESH_BINARY, 31, 11)
    blur = cv2.GaussianBlur(base, (3, 3), 0)
    return [('gray', base), ('otsu', otsu), ('adap', adap), ('blur', blur)]


def _words(img, config: str, lang: str):
    import pytesseract
    from pytesseract import Output
    d = pytesseract.image_to_data(img, lang=lang, config=config, output_type=Output.DICT)
    out = []
    for i in range(len(d['text'])):
        t = _half(str(d['text'][i])).strip()
        try:
            c = float(d['conf'][i])
        except (TypeError, ValueError):
            c = -1.0
        if not t or c < OCR_MIN_CONF:
            continue
        out.append({'text': t, 'conf': c, 'l': int(d['left'][i]), 't': int(d['top'][i]),
                    'w': int(d['width'][i]), 'h': int(d['height'][i]),
                    'cy': int(d['top'][i]) + int(d['height'][i]) / 2.0,
                    'cx': int(d['left'][i]) + int(d['width'][i]) / 2.0})
    return out


def _lines(words):
    ws = sorted(words, key=lambda w: (w['cy'], w['l']))
    hs = sorted(w['h'] for w in ws)
    tol = (hs[len(hs) // 2] * 0.9) if hs else 1.0
    lines = []
    for w in ws:
        for ln in lines:
            if abs(w['cy'] - ln['cy']) <= max(tol, ln['h'] * 0.9):
                ln['ws'].append(w)
                n = len(ln['ws'])
                ln['cy'] = (ln['cy'] * (n - 1) + w['cy']) / n
                ln['h'] = max(ln['h'], w['h'])
                break
        else:
            lines.append({'cy': w['cy'], 'h': w['h'], 'ws': [w]})
    for ln in lines:
        ln['ws'].sort(key=lambda w: w['l'])
        ln['text'] = ' '.join(w['text'] for w in ln['ws'])
    return sorted(lines, key=lambda ln: ln['cy'])


def _find_date(lines):
    best, score = None, 0.0
    for ln in lines:
        txt = ln['text']
        for m in DATE_RE.finditer(txt):
            iso = _valid_date(int(m.group(1)), int(m.group(2)), int(m.group(3)))
            if not iso:
                continue
            s = 0.55
            up = txt.upper()
            if '日期' in txt or 'WATER' in up or 'METER' in up:
                s += 0.25
            if m.start() <= 2:
                s += 0.15
            s += min(0.05, 0.01 * sum(1 for w in ln['ws'] if w['conf'] >= 60))
            if s > score:
                best, score = iso, min(0.98, s)
    return best, score


def _money_candidates(lines):
    cands = []
    for ln in lines:
        for w in ln['ws']:
            t = w['text'].replace(',', '.')
            if not NUM_RE.match(t):
                continue
            core = t.strip('¥¥元')
            try:
                v = float(core)
            except ValueError:
                continue
            if not (0.0 < v <= MAX_MONEY):
                continue
            if '.' in core and len(core.split('.')[1]) > 2:
                continue
            cands.append({'v': v, 'ln': ln, 'w': w, 'tok': t})
    return cands


def _find_amount(lines):
    cands = _money_candidates(lines)
    if not cands:
        return None, None, 0.0
    best, bscore, bccy = None, 0.0, None
    for c in cands:
        txt = c['ln']['text']
        up = txt.upper()
        is_total = any(k in txt for k in TOTAL_LABELS)
        is_spend = any(k in txt for k in SPEND_LABELS) and '元' in txt
        s = 0.35
        if is_total:
            s += 0.45
        elif is_spend:
            s += 0.40
        ccy = None
        for sym, cc in SYMBOL_CCY.items():
            if sym in c['tok'] or sym in txt or sym in up:
                ccy = cc
                s += 0.10
                break
        s += min(0.10, 0.05 * (c['w']['conf'] / 100.0) + 0.05 * (c['ln']['h'] > 0))
        if s > bscore:
            best, bscore, bccy = c['v'], s, ccy
    tied = [c for c in cands if abs((0.35 + (0.45 if any(k in c['ln']['text'] for k in TOTAL_LABELS)
            else (0.40 if any(k in c['ln']['text'] for k in SPEND_LABELS) and '元' in c['ln']['text'] else 0.0))) - bscore) < 1e-6]
    if len(tied) > 1 and len({c['v'] for c in tied}) > 1:
        bscore -= 0.15
    return (best if bscore >= RETURN_THR else None), bccy, min(0.98, max(0.0, bscore))


def _find_reading(digit_words, full_text_nospace):
    ds = [w for w in digit_words if re.fullmatch(r'\d', w['text'])]
    if len(ds) < READING_MIN:
        return None, 0.0
    lines = _lines(ds)
    best, bscore = None, 0.0
    for ln in lines:
        ws = sorted(ln['ws'], key=lambda w: w['l'])
        if not (READING_MIN <= len(ws) <= READING_MAX):
            continue
        hmax = max(w['h'] for w in ws)
        hmin = min(w['h'] for w in ws)
        if hmin <= 0 or hmax / hmin > 1.8:
            continue
        cxs = [w['cx'] for w in ws]
        gaps = [b - a for a, b in zip(cxs, cxs[1:])]
        medw = sorted(w['w'] for w in ws)[len(ws) // 2]
        if medw <= 0 or (gaps and max(gaps) > 3.0 * medw):
            continue
        mean_conf = sum(w['conf'] for w in ws) / len(ws) / 100.0
        consist = 1.0 - (max(gaps) - min(gaps)) / max(gaps) if gaps and max(gaps) > 0 else 0.0
        s = 0.30 + 0.50 * mean_conf + 0.18 * max(0.0, consist)
        rd = ''.join(w['text'] for w in ws)
        if rd and rd in full_text_nospace:
            s += 0.05
        if s > bscore:
            best, bscore = rd, s
    return (best if bscore >= RETURN_THR else None), min(0.98, max(0.0, bscore))


def _find_item(lines, date_iso):
    for ln in lines:
        for lab in NAME_LABELS:
            if lab in ln['text']:
                rest = ln['text'].split(lab, 1)[1].lstrip(' ::')
                if rest and not any(ch.isdigit() for ch in rest) and 1 <= len(rest) <= 24:
                    return rest, 0.85
    if date_iso:
        for ln in lines:
            m = DATE_RE.search(ln['text'])
            if m:
                tail = ln['text'][m.end():].strip()
                if tail and not any(ch.isdigit() for ch in tail) and 1 <= len(tail) <= 16 \
                        and not any(k in tail for k in SPEND_LABELS + TOTAL_LABELS):
                    return tail, 0.70
                break
    return None, 0.0


def _find_quantity(lines):
    for ln in lines:
        m = QTY_RE.search(ln['text'])
        if m:
            q = int(m.group(1))
            if 1 <= q < 10000:
                return q, 0.85
    return None, 0.0


def _classify(full_text, reading, reading_conf, has_name, has_total):
    up = full_text.upper()
    if ('WATER' in up and 'METER' in up) or (reading is not None and reading_conf >= 0.75):
        return 'meter', 0.9 if ('WATER' in up and 'METER' in up) else 0.7
    if '零售小票' in full_text or (has_name and has_total):
        return 'receipt', 0.9 if '零售小票' in full_text else 0.75
    if any(k in full_text for k in SPEND_LABELS) and '元' in full_text:
        return 'note', 0.8
    return None, 0.0


def _parse_once(lines, digit_words):
    full_text = '\n'.join(ln['text'] for ln in lines)
    nospace = re.sub(r'\s+', '', full_text)
    date_iso, dconf = _find_date(lines)
    amount, ccy, aconf = _find_amount(lines)
    reading, rconf = _find_reading(digit_words, nospace)
    item, iconf = _find_item(lines, date_iso)
    qty, qconf = _find_quantity(lines)
    has_name = any(lab in full_text for lab in NAME_LABELS)
    has_total = any(lab in full_text for lab in TOTAL_LABELS)
    doc, docconf = _classify(full_text, reading, rconf, has_name, has_total)
    if doc == 'meter':          # 表计卡没有金额负载
        amount, ccy, aconf = None, None, 0.0
        item, iconf = (item, iconf) if item else (None, 0.0)
        qty, qconf = None, 0.0
    if amount is None:
        ccy = None
    cconf = 0.9 if (ccy and amount is not None) else 0.0
    fields = {'doc_type': doc, 'date': date_iso, 'item': item, 'quantity': qty,
              'amount': amount, 'currency': ccy, 'reading': reading}
    conf = {'doc_type': round(docconf, 3), 'date': round(dconf, 3), 'item': round(iconf, 3),
            'quantity': round(qconf, 3), 'amount': round(aconf, 3),
            'currency': round(cconf, 3), 'reading': round(rconf, 3)}
    core = [('date', date_iso, dconf), ('amount', amount, aconf), ('reading', reading, rconf)]
    got = [c for _, v, c in core if v is not None]
    conf['overall'] = round(sum(got) / len(got), 3) if got else 0.0
    return fields, conf


def parse(image_path) -> dict:
    out = dict(_EMPTY)
    conf = {'doc_type': 0.0, 'date': 0.0, 'item': 0.0, 'quantity': 0.0,
            'amount': 0.0, 'currency': 0.0, 'reading': 0.0, 'overall': 0.0}
    try:
        bgr = _load_bgr(image_path)
        best_fields, best_conf, best_key = None, None, -1.0
        for name, img in _variants(bgr):
            ws = _words(img, '--psm 6', 'chi_sim+eng')
            dw = _words(img, '--psm 6 -c tessedit_char_whitelist=0123456789', 'eng')
            lines = _lines(ws)
            if not lines:
                continue
            f, c = _parse_once(lines, dw)
            if c['overall'] > best_key:
                best_fields, best_conf, best_key = f, c, c['overall']
        if best_fields is None:
            out['error'] = 'no_text'
            return {**out, 'confidence': conf}
        return {**out, **best_fields, 'confidence': best_conf}
    except Exception as e:                       # 引擎缺失/文件不可读等:拒识而非猜测
        out['error'] = f'{type(e).__name__}: {e}'
        return {**out, 'confidence': conf}
```

## 会让解析器失效的三种输入

1. **带红色小数位的表计 / 多排字轮**:读数抽取假设“≥5 个等高、等距、纯整数的单数字 token 排在同一水平带”。水/电/气表常见的末位红字(小数)或上下两排字轮会被并入同一行或拆成两行,导致把小数位当整数、或选中错误那一排;几何一致性检查一旦失败则 reading=None。
2. **金额模型不匹配的票据**:含千分位(`1,234.5`)、超过 2 位小数、非 ¥/$/€ 符号,或小票没有“合计”而同时存在“单价×数量/优惠/实收/找零”等多个数字。关键词同行关联会选错 token;若最高分出现并列歧义或金额超过 2 位小数,按 R4 降分/拒识,amount=None(不会把最大数当总价猜)。
3. **日期或标签—值几何被破坏**:两位年、汉字大写日期、世纪超出 `(?:19|20)`,或强透视/旋转/反光使“品名”行与“合计”行在 OCR 行聚类中合并、标签与值既不同行也不是右侧最近 token。日期真值校验或“同行关联”失败,对应字段按规则落到 None;若整行聚类错乱(竖排版、弧形小票),多字段同时失效且 overall→0。L4 · 脚本真实算出的分数 · stealth/ox-alphaSCORES
10 张 holdout × 3 字段(amount / date / item)全部未命中,F1 记 0。按 rubric 口径(字段级 F1 × 40)折合 0 分。注意失败原因特殊,见下方 Findings。
打分器约定:未检出硬编码记 1.0、检出记 0.0 并一票否决。本次在代码全文中搜索任一 holdout 数值均未命中——cheat_detected=false,flags=[],未触发归零。
本次自动化运行的 score 记录中没有这两个维度的数值(后者属 judge 主观维度,需另行评审)。本页如实留白,不做推测补齐。
| holdout 图 | 真值版式 | 真值 amount | 真值 date | 真值 item | 模型解析输出 parsed | 命中 金额/日期/品名 |
|---|---|---|---|---|---|---|
s05.png | meter(表计) | 332.02 | 2026-07-24 | 纸巾 | {} | — — — |
s06.png | receipt(打印小票) | 112.64 | 2026-08-16 | 灯泡 | {} | — — — |
s07.png | ledger(手写账本) | 367.17 | 2026-05-01 | 胶带 | {} | — — — |
s08.png | meter(表计) | 443.27 | 2026-02-06 | 插座 | {} | — — — |
s09.png | receipt(打印小票) | 358.77 | 2026-12-23 | 胶带 | {} | — — — |
s10.png | ledger(手写账本) | 151.19 | 2026-10-16 | 胶带 | {} | — — — |
s11.png | meter(表计) | 234.67 | 2026-12-26 | 胶带 | {} | — — — |
s12.png | receipt(打印小票) | 321.76 | 2026-06-18 | 水管接头 | {} | — — — |
s13.png | ledger(手写账本) | 58.94 | 2026-03-17 | 胶带 | {} | — — — |
s14.png | meter(表计) | 229.52 | 2026-05-23 | 胶带 | {} | — — — |
10 行的沙箱 stderr 完全相同(仅临时目录哈希不同,results/C01.json 的 per_holdout_image 各存一份),代表性原文如下。另两份 JSON 同构:results/moonshotai__kimi-k3/C01.json 的 10 行 parsed 同样全为 {}、hit 全 false(stderr 为同一类 SyntaxError,见 L5);results/z-ai__glm-5v-turbo/C01.json 的 10 行 parsed 均为 {"error": "exception_in_code"}、hit 同样全 false。
File "/var/folders/xj/t3j4l0md7_b3lsy_m4zkr1780000gn/T/sbx_okwbd76f/script.py", line 9
    from __future__ import annotations
    ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
SyntaxError: from __future__ imports must occur at the beginning of the fileL5 · 三模型分数对比THREE-MODEL SCORES
两个 deterministic 维度三家都有脚本算出的真值(色条样式与取值口径同 compare.html);judge 主观维度(拒识正确性 30、失效场景预判 30)在三份 score 记录里都没有数值,如实留白、不做推测补齐。
反作弊守门三家一致:cheat_detected=false、flags=[],硬编码惩罚均记 1.0(打分器约定:未检出硬编码记 1.0、检出记 0.0 并一票否决)。F1 虽同为 0,但直接原因并不相同——各家代表性沙箱报错如下(每家 10 张 holdout 的报错文本各自完全相同,仅临时目录哈希不同)。
File "/var/folders/xj/t3j4l0md7_b3lsy_m4zkr1780000gn/T/sbx_9b9sww3j/script.py", line 4
    from __future__ import annotations
    ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
SyntaxError: from __future__ imports must occur at the beginning of the filekimi-k3(拼接后第 4 行)与上方 L4 中 ox-alpha(第 9 行)是同一根因:from __future__ import annotations 被沙箱缩进包裹后不再位于文件开头。
Traceback (most recent call last):
  File "/var/folders/xj/t3j4l0md7_b3lsy_m4zkr1780000gn/T/sbx_0zjcmbcd/script.py", line 8, in <module>
    import pytesseract
ModuleNotFoundError: No module named 'pytesseract'glm-5v-turbo 则是另一类失败:代码本身能通过语法检查,但在 import pytesseract 阶段因沙箱未安装该 OCR 依赖直接崩溃(parsed 记为 {"error": "exception_in_code"})——它的解析逻辑同样从未得到一次真实执行机会。
- 10/10 全部执行失败,这个 0 分并不是解析能力的测量。每张 holdout 图的沙箱运行都在语法检查阶段抛出同一错误:
SyntaxError: from __future__ imports must occur at the beginning of the file(拼接后脚本的第 9 行)。parse()从未被真正调用,因此 parsed 全为空对象、三个字段全部 miss,F1=0.000 是脚本按此如实算出的结果。 - 根因在装载方式,不在语法本身。经核对
harness/sandbox.py:沙箱把模型代码逐行加 4 空格缩进包进try:块后再执行。模型把from __future__ import annotations写在自己模块 docstring 之后——独立成文件时完全合法,被缩进包裹后便不再位于文件开头,Python 直接拒绝编译。也就是说,模型这次提交的解析逻辑从未得到一次真实执行机会。 - 回复质量与反作弊均过关。finish_reason=
stop;模型按要求给出了三类版式的归纳规则与适用边界、OCR 双后端方案、置信度模型和三条具体的失效场景;代码中不含任何 holdout 数值(cheat_detected=false)。 - 规模口径。设计稿为 15 张 holdout,本次实际数据与运行为 10 张(s05–s14),F1 分母 = 30 个字段。
results/C01.json的 limitations 原文:「样本规模为演示级缩小版(1),非原始题库规模」。 - 三模型对比:F1 全部为 0,但失败模式分两类。ox-alpha 与 kimi-k3 是同一根因——两者都把
from __future__ import annotations写在模块头部附近,被沙箱缩进包裹后不再位于文件开头,分别在拼接后第 9 / 第 4 行触发同一个 SyntaxError;glm-5v-turbo 的代码能通过编译,却把 OCR 引擎写成硬依赖、没有降级路径,import pytesseract即崩。三家的解析逻辑都没能得到一次真实执行机会。 - 反作弊与输出纪律三家一致过关。cheat_detected 均为 false、flags 均为空;三家都按题意交出了规则归纳、完整代码与具体成文的失效场景,代码里都没有出现样本或 holdout 数值。
- 输出规模的差异肉眼可见,但解读要克制。completion tokens:11,804 / 5,859 / 10,479(ox-alpha / glm-5v-turbo / kimi-k3),OpenRouter 记录成本 $0 / $0.0247128 / $0.160992,usage 单列 reasoning tokens 0 / 1,920 / 5,818。结合页首的方法论局限(推理深度配置不同),输出长短与成本差异不能当作能力差距的证据。