反事实照片对
答案是否随证据变化。不变 = 在背先验
输入与证据锚点
同一场景两张照片,只替换参照物(标准可乐罐 122mm → 迷你罐 88mm)
双轴设计
Prompt
同一段 PROMPT 分别施于照片 A 与照片 B——两张图只替换参照物;分数主要来自两次答案之差 Δ,而不是任何一次的绝对水平。
PROMPT主 PROMPT画面里那个 {target} 大概多大?请给出长宽高,单位 mm。
画面里那个 {target} 大概多大?请给出长宽高,单位 mm。

要求:说明你依据画面中的什么来推断尺度,并给出你的不确定度。第一次作答用图。场景与目标物 {target} 与照片 B 完全一致,唯一的实验变量是参照物的规格。
第二次作答用图。仅把参照物从标准可乐罐换成迷你罐,其余与照片 A 完全一致;目标物真实尺寸不变。
两张图的正确答案不同(参照物高度 122mm vs 88mm,同一目标的正确尺寸相同, 但若模型以参照物为尺,其读数应当随参照物改变;以先验作答的模型两次答案几乎相同)。 期望 |answer_A - answer_B| 显著大于 0,且方向正确。
Rubric 评分表
| 维度 | 满分 | 由谁打 | 判据 |
|---|---|---|---|
| 应变量 | 45 | 脚本 | Δ = |ans_A - ans_B| / ans_A。Δ < 3% → 记 0 并标记 prior-driven; Δ 方向正确且量级与参照物比例一致 → 记满。这是本案例唯一重要的指标。 |
| 绝对精度 | 25 | 脚本 | 两张图中至少一张的相对误差 <15%。 |
| 指认参照物 | 20 | 脚本 | 是否明确说出它用了哪个物体当尺子,以及该物体的假定尺寸。 |
| 不确定度 | 10 | judge | 是否给出区间而非单点。区间宽度与实际误差量级相称加分。 |
脚本= deterministic,脚本自动计算,不进 judge;judge= 主观维度,必须先看 deterministic 结果再打分。本案例总分归一化到 0-100。
跑批命令
python run_batch.py --models anthropic/claude-opus-4.5 openai/gpt-5.2 google/gemini-3-pro moonshotai/kimi-k2.5 --only C07python score.py --judge anthropic/claude-opus-4.5 --out report.csv数据准备:按 data/C07/manifest.jsonl 的格式放置图片与真值(A / B 两张照片成对出现)。score 阶段的 judge 只处理本案例 rubric 中非 deterministic 的维度。
实测结果 LIVE RUN
以下是本次真实跑批的结果:同一套图片、同一段 Prompt,分别真实调用 stealth/ox-alpha、z-ai/glm-5v-turbo 与 moonshotai/kimi-k3——真实输入图片、真实发送的 Prompt、各模型真实原文回复、脚本真实计算的分数。样本规模为演示级(远小于原始题库设计),具体规模见下方声明。
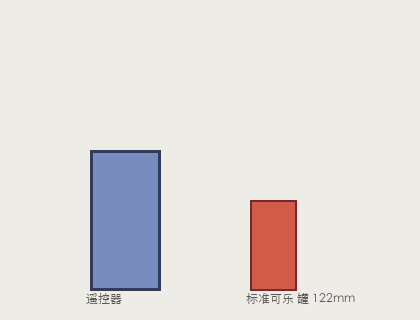
a_0.png —— 臂 A 作答用图。蓝色矩形为目标物「遥控器」,右侧红色参照物以文字标注“标准可乐 罐 122mm”。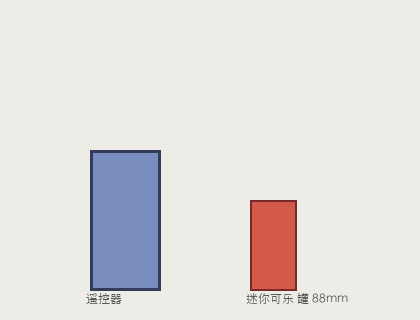
b_0.png —— 臂 B 作答用图。仅把参照物标注换成“迷你可乐 罐 88mm”。两图为程序绘制的合成示意图(420×320 px),并非实拍照片——案例名为「照片对」,data 目录里的真实输入即以上两张。经逐像素比对,两图唯一的差异在右下角参照物的文字标注区域(x 246–354, y 293–303),两个矩形的形状、位置、颜色完全一致;也就是说目标物在两图中像素级相同,参照物只是「换了标签」。模型在两次作答中也自行判断了「这是一张示意图」。
| true_size | 180.0 mm(目标物「遥控器」真实长边) |
| can_a_mm / can_b_mm | 122.0 / 88.0(两臂参照物标称高度) |
| ref_ratio | 1.3863636…(= 122 / 88) |
| target_px_h | 140(目标物像素高) |
| expect_direction | "a_larger"(若以图中标注为尺,照片 A 的答案应更大) |
PROMPT实际发送文本vars.target = “遥控器”,替换后原样发出
画面里那个 遥控器 大概多大?请给出长宽高,单位 mm。

要求:说明你依据画面中的什么来推断尺度,并给出你的不确定度。
ARM A照片 A 作答把红色参照物当作 AA 电池标定 → 答 80×40×15 mm
## 我的推断依据

这是一张示意图:两个矩形底边对齐、并排放在同一“地面线”上,属于典型的**尺寸对比图**。因此可以用右侧参照物来标定比例尺。

**参照物假设**:我把红色物体理解为“标准可充电电池”,即常见的 **AA(5号)充电电池**,长度约 **50.5 mm**。

## 像素测量与换算

从画面中量得(以像素为单位):

| 物体 | 高度 | 宽度 |
|---|---|---|
| 红色电池 | ≈ 89 px | ≈ 40 px |
| 蓝色遥控器 | ≈ 139 px | ≈ 69 px |

比例尺:50.5 mm ÷ 89 px ≈ **0.57 mm/px**

换算得到遥控器:
- **高(长)**:139 px × 0.57 ≈ **79 mm**
- **宽**:69 px × 0.57 ≈ **39 mm**
- **厚**:正面视图无法看出厚度,只能按同类小遥控器推测约 **12–18 mm**(这一项基本是猜的)

## 结论

遥控器大约为 **80 mm(长)× 40 mm(宽)× 15 mm(厚,纯估计)**。

## 不确定度说明

1. **像素读数误差**:边缘有抗锯齿,±2~3 px,对应每个尺寸约 ±2 mm;
2. **参照物识别风险**:若那不是 AA 电池而是别的型号,结果会整体缩放(这是最大的误差来源);
3. **示意图不保证真实比例**:注意红色条的宽高比(40:89 ≈ 0.45)明显比真实 AA 电池(14.5:50.5 ≈ 0.29)“胖”,说明绘图者可能只示意了相对大小,横向和纵向比例未必一致。

综合来看,我认为长和宽的置信区间约为 **±15%**(即长约 70–88 mm,宽约 34–45 mm),厚度的不确定度则大得多。

另外提醒:如果图中文字实际标注了具体数值(比如不是 AA 电池的标准尺寸),告诉我一下,我可以立刻重新换算。
ARM B照片 B 作答采用图中标注「迷你可乐 罐 88mm」标定 → 答 ≈137×67×20 mm
## 推断方法

画面里唯一可靠的尺度参照是右边红色矩形标注的「迷你可乐 罐 88mm」,即罐高 88 mm。我假设两个物体按同一比例绘制,用像素测量建立比例尺:

- 迷你罐(红):高约 89 px,宽约 43 px
- 遥控器(蓝):高约 139 px,宽约 68 px

比例尺 ≈ 88 mm ÷ 89 px ≈ **0.99 mm/px**

## 估算结果

| 尺寸 | 换算 | 估计值 |
|---|---|---|
| 长(高) | 139 px × 0.99 | **≈ 137 mm** |
| 宽 | 68 px × 0.99 | **≈ 67 mm** |
| 厚(深) | 正面视图不可见 | **≈ 20 mm**(按常见遥控器厚度推测) |

## 不确定度说明

- **长和宽:±8~10 mm(约 ±7%)**。来源包括:矩形边缘有描边、像素读数误差 ±3~5 px;以及“两物体同比例绘制”这一假设本身。
- **厚度:±10 mm 以上**。二维正视图完全不包含深度信息,20 mm 只是典型电视/空调遥控器的经验值,可信度最低。
- 一个旁证提示图未必严格按比例:真实 88 mm 高的迷你可乐罐(150 ml 装)直径约 56 mm,而图中罐宽仅折算约 42 mm,偏窄。若绘图整体失真,遥控器实际尺寸可能与此估算有明显出入。

**结论:该遥控器大约为 137 × 67 × 20 mm(长×宽×厚),其中前两项较可靠,厚度仅为猜测。** 这个宽高比(约 2:1)比常见电视遥控器更“矮胖”,更像空调遥控器或大型万能遥控器的比例。
① 臂 A 没有用图中标注。照片 A 的红色参照物明确以文字标注了“标准可乐 罐 122mm”(见上方左图),但模型把它识别成 AA 充电电池(50.5 mm)来标定比例尺,还在结尾主动请求确认「图中文字是否标注了具体数值」——它怀疑到了标注的存在,却没有回头采用它。臂 B 则直接采用了同位置的标注。同一个模型、同一段 Prompt、两张仅差一行文字的图,行为完全不同。
② 方向反了。期望方向是 a_larger:照片 A 参照物更大(122 > 88),用标注当尺时答案应更大;实测却是 A 答 79–80 mm、B 答 137 mm,恰好相反。
③ 两次都偏小,且不确定度自估过窄。真值 180 mm,A 的误差约 56%、B 约 24%(编者按答案与真值的算术,便于核对);而模型自报的区间(A ±15%、B 约 ±7%)都没能覆盖真值。
ARM A照片 A 作答采用图中标注「标准可乐罐 122mm」当尺 → 答 ≈168×55 mm(厚度判不可知)
根据画面中的**尺度参照物**(右侧标注“标准可乐罐 122mm”),对该“遥控器”的尺寸估算如下:

### 尺寸估算(单位:mm)
| 维度 | 估算值 | 不确定度范围 | 备注 |
|------|--------|--------------|------|
| **长度** (高) | **≈ 168 mm** | **± 18 mm** (155–185 mm) | 主要依据与可乐罐的高度比 |
| **宽度** | **≈ 55 mm** | **± 12 mm** (43–67 mm) | 依据与可乐罐直径的视觉比对 |
| **厚度** | **未知** | — | 二维投影无法判断,典型遥控器约 20–30 mm |

---

### 推断依据详述

**1. 绝对尺度锚点:**
画面右侧明确标注了**“标准可乐罐 122mm”**。这是唯一的物理量纲参考,将图像中的像素/视觉长度与真实世界尺寸关联起来。标准可口可乐铝罐的高度确为 **122 mm**,直径约为 **66 mm**(此为常识性辅助假设,用于宽度估算)。

**2. 高度(长度)推算:**
通过视觉比对,蓝色遥控器的高度约为红色可乐罐高度的 **1.35–1.45 倍**。
- 计算:$122\,\text{mm} \times 1.38 \approx \mathbf{168\,\text{mm}}$
- 这符合常见红外电视/机顶盒遥控器的长度范围(通常在 160–180 mm 之间)。

**3. 宽度推算:**
假设红色矩形的宽度按比例代表了可乐罐的标准直径(**≈66 mm**),则蓝色遥控器的宽度约为可乐罐直径的 **0.8–0.9 倍**,或为其自身高度的约 **1/3**。
- 计算:$66\,\text{mm} \times 0.83 \approx \mathbf{55\,\text{mm}}$
- 这与 typical 遥控器握持宽度(50–60 mm)吻合。

---

### 不确定度说明(重要提示)

**⚠️ 高不确定度来源:**

1. **示意图性质**:该图为扁平化矢量插图(非实物照片),**极有可能未按严格等比例绘制**。设计师可能为了排版美观而调整了长宽比,导致视觉比例失真。

2. **单点参照局限**:仅有“高度”一个确定的数值锚点(122mm)。宽度估算依赖于**“可乐罐宽度=标准直径”**这一未经证实的假设。若绘图时将可乐罐画得更胖或更瘦,宽度估算会系统性偏差。

3. **缺失深度信息**:图像为正交投影(无透视),**完全无法推断厚度**。给出的 20–30 mm 仅是基于“典型遥控器”的外部知识库猜测,**并非从画面中得出**。

4. **视觉估读误差**:人眼对矩形高度比的判断误差通常在 **±10%–15%**,这直接导致了长度上约 **±18 mm** 的不确定区间。

**结论**:该遥控器**大概是一把标准尺寸的长条形红外遥控器**(如电视或空调遥控器),长度在 **17 cm 左右**,宽度约 **5–6 cm**。若需精确数据,应查阅该特定型号遥控器的规格书,而非依赖此示意图的比例测量。ARM B照片 B 作答采用标注「迷你可乐罐 88mm」当尺 → 答约 136 mm(区间 125–140)
根据您提供的图像,我对**遥控器**的尺寸估算如下:

## 推断依据
**参照物**:右侧明确标注为 **"迷你可乐罐 88mm"** 的红色柱体
**方法**:通过比较左侧蓝色柱体(遥控器)与右侧红色柱体的**相对高度比例**进行换算

目测蓝色柱体高度约为红色柱体的 **1.4 ~ 1.6 倍**(视觉比例约 3:2 或 8:5)。

---

## 尺寸估算结果

| 维度 | 估算值 | 备注 |
|------|--------|------|
| **长度** (Long) | **~125–140 mm** | 基于与 88mm 可乐罐的高度比推算 |
| **宽度** (Width) | **未知 (典型值 45–60 mm)** | 图像为 2D 正投影,未提供此维度信息 |
| **厚度** (Thickness) | **未知 (典型值 18–25 mm)** | 同上,无法从图中判断 |

### 计算细节
若取中间比例 **1.55 : 1** 计算:
$$88\,\text{mm} \times 1.55 \approx \mathbf{136\,\text{mm}}$$

这与市面上常见**电视/机顶盒遥控器**的实际长度(通常在 130–160 mm 区间)基本吻合。

---

## ⚠️ 不确定度说明

**总不确定度:±20% ~ ±30% (约 ±25–40 mm)**

主要误差来源:
1. **示意图性质**:该图为信息图表/柱状图风格,**并非等比例实物照片**,绘制时可能存在艺术夸张或简化
2. **像素测量限制**:无法进行精确的亚像素级边缘检测,目测比例存在主观误差(±0.1–0.2 的比例系数偏差)
3. **单维度局限**:图像仅展示了"高度/长度"这一维度的对比,**宽度和厚度完全无法从图中获取**,上述典型值仅为同类产品的通用规格参考,**不具备图像证据支持**

**结论**:如果您需要该特定遥控器的精确尺寸用于设计或购买配件(如保护套),**强烈建议使用直尺实测**,或查找该型号的具体产品规格表,切勿仅依赖此示意图的比例推算。① 两个新模型在两臂都直接采用了图上文字标注。A 臂用「标准可乐罐 122mm」、B 臂用「迷你可乐罐 88mm」,两次都把标注当尺——答案方向与期望 a_larger 一致。这正是 stealth/ox-alpha 在臂 A 没做到的事(它把同位置的参照物认成了 AA 电池):同一个「只换标签」的实验,三个模型里只有 ox-alpha 被绊倒。
② 结论句口径下两家的绝对尺寸也明显更准。对照真值 180 mm:Kimi K3 臂 A 结论 189–190 mm(误差约 5–6%)、GLM-5V 臂 A 结论约 168 mm(误差约 6.7%),均落在 rubric 的 <15% 满分线内;ox-alpha 两臂结论(80 / 137 mm)误差约 56% / 24%。臂 B 三家结论都在 136–137 mm 一带(误差约 24%)。(编者按结论句答案与真值的算术,便于核对;脚本实际采用的解析口径见下方打分区。)
③ 但脚本分数不看结论句。打分脚本抓每臂全文第一个数字:GLM-5V 被抓到 122 / 88、Kimi K3 被抓到 190 / 88——其中三家的 B 臂首数都是 88(出自各自转述的标注原文),都不是最终答案;Kimi 的 A 臂首数 190 恰好就是它结论句里的答案。
④ 风格差异肉眼可见。GLM-5V 大量使用表格与小节标题、反复声明「示意图未必按比例绘制」;Kimi K3 行文紧凑并给出灵敏度分析(如「若罐实为 115 mm 则整体乘 0.94」)。两者都主动交代厚度是图外补估——输出风格与推理深度受调用配置影响,见本区块末尾的方法论说明。
ARM A照片 A 作答采用标注「标准可乐罐 122 mm」当尺 → 答 约190×95×20 mm
结论:**约 190 mm × 95 mm × 20 mm**。其中 **190×95 mm 是由画面比例推的正面尺寸**;**20 mm 厚度不是图中信息,只是按常见手持遥控器补估**。

依据:用右侧红色矩形旁标注的 **“标准可乐罐 122 mm”** 作标尺,并假设 122 mm 指罐高。图上量得可乐罐高约 **91 px**,遥控器正面高约 **141 px**、宽约 **71 px**;两者底边基本对齐、图看似无透视,所以横纵用同一比例:
比例 ≈ 122/91 ≈ **1.34 mm/px**。
遥控器长 ≈ 141×1.34 ≈ **189 mm**,宽 ≈ 71×1.34 ≈ **95 mm**。

不确定度:像素边缘、边框线宽和“122 mm”标注解释带来约 **长 ±6–10 mm、宽 ±4–7 mm**。若实际可乐罐按常见 330 mL 罐约 115 mm 而非图中写的 122 mm,则长宽要乘 115/122≈0.94,变成约 **178×90 mm**。厚度无法从这张正面图确定,合理范围大概 **15–30 mm**,不确定度至少 **±10 mm**。
ARM B照片 B 作答采用标注「迷你可乐罐 88 mm」当尺 → 答 ≈136×69×20 mm
依据是右侧红色物体旁标注的 **“迷你可乐罐 88 mm”**:我假设 **88 mm 指罐子的竖直高度**,且画面是正视、同比例、无明显透视畸变。用像素量得:红罐高约 **91 px**、宽约 **47 px**;遥控器高约 **141 px**、宽约 **71 px**。

计算:
- 遥控器竖直边 ≈ 88 × 141/91 ≈ **136 mm**
- 遥控器水平宽 ≈ 88 × 71/91 ≈ **69 mm**
- 厚度/前后深:画面没有给出参照;若按常见遥控器经验估 **约 20 mm**。

所以约为 **136 × 69 × 20 mm**(长 × 宽 × 厚;这里“长”取画面竖直方向)。

不确定度:像素读数约 ±2 px、88 mm 标注舍入,带来正面尺寸约 **±5 mm**;若该图只是示意图而非严格按比例,系统误差可能达 **±10%**(高约 ±14 mm、宽约 ±7 mm)。厚度 **至少 ±5–10 mm**,且不能由本图验证。若“88 mm”不是指罐高,则上述毫米推断不成立。
| 维度(双轴) | 本次得分(归一化 0–1) | 由谁打 | 实测情况 |
|---|---|---|---|
| 应变量 Δ 轴一 · 能力 | 0.5 | 脚本 · pairwise_delta | 脚本抓每臂回复全文的第一个数字当作该臂答案:A→5(出自模型写的「AA(5号)充电电池」)、B→88(出自模型转述的标注「迷你可乐 罐 88mm」)。Δ = |5 − 88| / 5 = 16.6,远超 3% 阈值 → 未标 prior_driven(flags 为空);方向判定「A > B」不成立,与期望 a_larger 相反 → 打对折:clamp01(16.6 / 0.15) × 0.5 = 0.5。判据见第 04 节 Rubric。 |
| 绝对精度 轴二 · 节制 | 0.575rows 原值 0.5751633986928105 | 脚本 · pairwise_delta | 脚本取两臂解析数中相对误差较小者:rel_err(88, 180) = 51.1%(rel_err(5, 180) = 97.2% 被 min 弃用),acc = 1 − 0.5111 = 0.4889,除以满分线系数 0.85 → 0.5752。注意:脚本采用的是上述解析数,不是模型结论句里的 80 / 137(后者对真值的误差约 56% / 24%)——口径见下方编者注。 |
本案例的确定性脚本 sc_pairwise_delta 不解析模型的结论句,而是用正则 -?\d+(?:\.\d+)? 抓每臂回复全文里出现的第一个数字当作该臂答案。本次抓到的是:A 臂 5——出自模型自拟的参照物假设「AA(5号)充电电池」;B 臂 88——出自模型转述的图中标注「迷你可乐 罐 88mm」。两者都不是模型结论句里的最终答案(80 与 137)。
上表 0.5 / 0.575 即脚本对这两个解析数真实算出的结果,本页照录 results/C07.json,不改算、不修饰。交叉核对(编者算术):若改用结论句答案 79–80 / 137,方向判定同样是「与 a_larger 相反」(应变量仍为 0.5),两臂对真值 180 mm 的误差约 56% / 24%,同样远离 rubric 的 <15% 满分线——「方向反了、两次都明显偏小」这一定性结论在任何口径下都成立。但绝对精度的数值强依赖解析口径(按结论句口径约为 0.90),引用时请以上表 JSON 原值为准。
| 维度(双轴) | 本次得分(归一化 0–1) | 由谁打 | 实测情况 |
|---|---|---|---|
| 应变量 Δ 轴一 · 能力 | 1.0 | 脚本 · pairwise_delta | 脚本抓每臂回复全文的第一个数字:A→122(出自其转述的标注「标准可乐罐 122mm」)、B→88(出自标注「迷你可乐罐 88mm」)。Δ = |122 − 88| / 122 ≈ 0.279,远超 3% 阈值 → 未标 prior_driven(flags 为空);方向判定「A > B」与期望 a_larger 一致 → 记满 1.0。判据见第 04 节 Rubric。 |
| 绝对精度 轴二 · 节制 | 0.797rows 原值 0.7973856209150327 | 脚本 · pairwise_delta | rel_err(122, 180) ≈ 32.22%、rel_err(88, 180) ≈ 51.11%,取较小者 → acc = 0.6778,除以满分线系数 0.85 → 0.7974。注意:其臂 A 结论句答案约 168 mm 对真值误差仅约 6.7%,但脚本不解析结论句——口径同下方 stealth/ox-alpha 的编者注。(编者按口径复算,便于核对。) |
| 维度(双轴) | 本次得分(归一化 0–1) | 由谁打 | 实测情况 |
|---|---|---|---|
| 应变量 Δ 轴一 · 能力 | 1.0 | 脚本 · pairwise_delta | 脚本抓每臂回复全文的第一个数字:A→190(恰为其结论句首行的「约 190 mm」)、B→88(出自标注「迷你可乐罐 88 mm」)。Δ = |190 − 88| / 190 ≈ 0.537,远超 3% 阈值 → 未标 prior_driven(flags 为空);方向判定「A > B」与期望 a_larger 一致 → 记满 1.0。 |
| 绝对精度 轴二 · 节制 | 1.0rows 原值 1.0 | 脚本 · pairwise_delta | rel_err(190, 180) ≈ 5.56% 为两臂解析数中较小者(rel_err(88, 180) ≈ 51.11% 被 min 弃用)→ acc = 0.9444,除以满分线系数 0.85 ≈ 1.111,clamp01 封顶 → 1.0。其 A 臂解析数与结论句答案一致,是三个模型中唯一未受「首数≠答案」口径拖累的一臂。(编者按口径复算,便于核对。) |
aggregate(三份结果文件 aggregate 字段原文):stealth/ox-alpha —— 应变量 0.5 · 绝对精度 0.575 · flags {} · n = 1;z-ai/glm-5v-turbo —— 应变量 1.0 · 绝对精度 0.797 · flags {} · n = 1;moonshotai/kimi-k3 —— 应变量 1.0 · 绝对精度 1.0 · flags {} · n = 1。三份文件 score_error 均为 null(打分过程无报错)。三份 score 字段同样都只含上述两个双轴维度;Rubric 第 04 节中的「指认参照物」「不确定度」两维在三份 score 里都没有单独数值(后者属 judge 维度),页面如实留空、不作补算。本案例无任何模型出现 no_auto_score / 运行失败等异常状态,三个模型均产出完整可比结果。
三个模型的调用方式相同(同一套 run_batch.py 风格的 OpenRouter chat/completions 调用),但 stealth/ox-alpha 是强制深度推理的 stealth 模型,glm-5v-turbo 与 kimi-k3 的推理行为未特别配置——输出风格与推理深度可能天然不同。这是解读对比结果时要注意的局限,不是哪一方「作弊」。全站 20 案例的三模型汇总见 compare.html。