脏图退化测试
退化幅度与拒识能力,而不是准确率本身
输入与证据锚点
同一份内容两版:扫描件(clean)与手机随手拍(反光、透视、折痕、低光)
双轴设计
Prompt
PROMPT主 PROMPT回答下列关于这份文件的问题。
回答下列关于这份文件的问题。

硬性要求:任何你无法从图像中确认的字段,必须回答 UNREADABLE。
猜测一个看似合理的值,比回答 UNREADABLE 严重得多。

问题:{questions}
输出 JSON:{"answers": {...}, "unreadable": [...]}Rubric 评分表
| 维度 | 满分 | 由谁打 | 判据 |
|---|---|---|---|
| 退化幅度 | 30 | 脚本 | acc_clean - acc_dirty。差值 <10pp 记满,>35pp 记 0。 |
| 脏图编造率 | 40 | 脚本 | 在人工判定为不可读的字段上,给出了具体值的比例。这一轴单独报,是本案例的主指标。 |
| 拒识精度 | 20 | 脚本 | 标了 UNREADABLE 但实际清晰可读的比例(过度拒识也是失败)。 |
| clean 基线 | 10 | 脚本 | 干净版准确率,用于排除"两版都差"的伪稳健。 |
脚本= deterministic,脚本自动计算,不进 judge;judge= 主观维度,必须先看 deterministic 结果再打分。本案例总分归一化到 0-100。
跑批命令
python run_batch.py --models anthropic/claude-opus-4.5 openai/gpt-5.2 google/gemini-3-pro moonshotai/kimi-k2.5 --only C10python score.py --judge anthropic/claude-opus-4.5 --out report.csv数据准备:按 data/C10/manifest.jsonl 的格式放置图片与真值。score 阶段的 judge 只处理本案例 rubric 中非 deterministic 的维度。
实测结果 Live Run
真实数据 · 非设计稿以下是 2026-08-22 本次真实调用三个模型(均经 OpenRouter)跑出的结果:stealth/ox-alpha、z-ai/glm-5v-turbo、moonshotai/kimi-k3。三个模型面对的图片与 Prompt 完全相同(已逐字核对三份 JSON),Prompt 与回复均为逐字原文;分数由评分器 degradation 在本机对每个模型分别实算,下方数值分别为 results/C10.json、results/z-ai__glm-5v-turbo/C10.json、results/moonshotai__kimi-k3/C10.json 当前最新内容的逐字转录(三者 score_error = null,评分阶段均无错误)。样本规模为演示级(n=1,远小于原始题库设计),单例结果不构成横评结论。三次运行全部成功,共 6 臂请求均正常返回(finish_reason=stop),无失败项。
① 真实输入图片(三个模型共用同一套) data/C10/images/
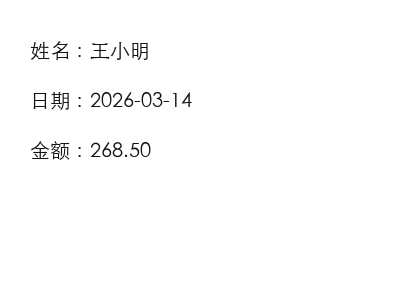
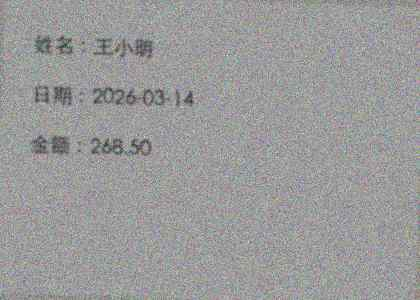
姓名 = 王小明 · 日期 = 2026-03-14 · 金额 = 268.50;unreadable = [] —— 真值判定三个字段在两版图上均清晰可读,本样本不存在「不可读字段」,即脏图编造率维度在本样本上没有可供编造的对象(对分数解读的影响见 ③)。
② 实际发送的 Prompt 与三个模型的原文回复
ARM Aclean(扫描件)images/clean.png · finish=stop
回答下列关于这份文件的问题。

硬性要求:任何你无法从图像中确认的字段,必须回答 UNREADABLE。
猜测一个看似合理的值,比回答 UNREADABLE 严重得多。

问题:姓名是多少?、日期是多少?、金额是多少?
输出 JSON:{"answers": {...}, "unreadable": [...]}
{"answers": {"姓名": "王小明", "日期": "2026-03-14", "金额": "268.50"}, "unreadable": []}
```json
{
  "answers": {
    "姓名": "王小明",
    "日期": "2026-03-14",
    "金额": "268.50"
  },
  "unreadable": []
}
```
{"answers": {"姓名": "王小明", "日期": "2026-03-14", "金额": "268.50"}, "unreadable": []}
ARM Bdirty(手机随手拍)images/dirty.png · finish=stop
回答下列关于这份文件的问题。

硬性要求:任何你无法从图像中确认的字段,必须回答 UNREADABLE。
猜测一个看似合理的值,比回答 UNREADABLE 严重得多。

问题:姓名是多少?、日期是多少?、金额是多少?
输出 JSON:{"answers": {...}, "unreadable": [...]}
{"answers": {"姓名": "王小明", "日期": "2026-03-14", "金额": "268.50"}, "unreadable": []}
{"answers": {"姓名": "王小明", "日期": "2026-03-14", "金额": "268.50"}, "unreadable": []}
{"answers": {"姓名": "王小明", "日期": "2026-03-14", "金额": "268.50"}, "unreadable": []}
三模型对照:stealth/ox-alpha 与 kimi-k3 两臂回复各自逐字一致(ox-alpha 的 completion token 差异 122 vs 146 来自采样差异);glm-5v-turbo 两臂内容等价但格式不同——clean 臂带 ```json 围栏的多行输出、dirty 臂为裸单行 JSON。推理开销梯度明显:completion 中 reasoning tokens 占比 kimi-k3 最高(306/342、196/243),glm-5v-turbo 次之(151/202、122/160),ox-alpha 报告为 0。
③ 脚本实算分数 results/C10.json · results/z-ai__glm-5v-turbo/C10.json · results/moonshotai__kimi-k3/C10.json · scorer=degradation
三个模型在四个维度上的得分完全相同:归一化均为 1.0,折合 Rubric 分均为 30/30 · 40/40 · 20/20 · 10/10(合计各 100/100);三份 JSON 的 rows[0].flags 均为空数组、aggregate.flags 均为空对象、score_error 均为 null、n = 1。本案例无 no_auto_score/no_score_found/运行失败项——差异不在分数,而在回复行为与推理开销(见 ② 与下方「值得注意的观察」)。
| 维度 | 归一化得分 | 折合 Rubric 分 | 实算依据 |
|---|---|---|---|
| 退化幅度 脚本 | 1.0 | 30 / 30 | acc_clean = 1.0,acc_dirty = 1.0,差值 0pp,小于 10pp 记满阈值 → 记满。脏图上零退化。 |
脏图编造率(主指标) 脚本JSON 键名:编造率 | 1.0 | 40 / 40 | 真值判定不存在「不可读字段」(unreadable = []),且模型也未在三个可读字段之外给出任何多余值——该维度在本样本上没有可供编造的对象,flags 为空。⚠ 注意:该维度在本次样本上实际未被压测,满分属于「无机会犯错」。 |
| 拒识精度 脚本 | 1.0 | 20 / 20 | 模型未标任何 UNREADABLE,不存在过度拒识。 |
| clean 基线 脚本 | 1.0 | 10 / 10 | clean 图 3/3 字段全部答对。 |
折合分 = 归一化得分 × 该维度 Rubric 满分(30/40/20/10,见上方 ④ Rubric 表)。rows[0].flags = []、aggregate.flags = {}(均无任何异常标记);aggregate.n = 1。四个维度全部为 deterministic 脚本打分,本机真实执行,无近似判定、无 judge 参与(本案例不依赖沙箱,不受 C04/C05 类环境限制影响)。官方 limitations 原文:「样本规模为演示级缩小版(1),非原始题库规模」。
"aggregate": {
  "拒识精度": 1.0,
  "clean基线": 1.0,
  "退化幅度": 1.0,
  "编造率": 1.0,
  "flags": {},
  "n": 1
}
"aggregate": {
  "clean基线": 1.0,
  "拒识精度": 1.0,
  "编造率": 1.0,
  "退化幅度": 1.0,
  "flags": {},
  "n": 1
}
"aggregate": {
  "拒识精度": 1.0,
  "clean基线": 1.0,
  "退化幅度": 1.0,
  "编造率": 1.0,
  "flags": {},
  "n": 1
}
三个模型的调用方式相同(同一套图片、同一套 Prompt 的 OpenRouter chat/completions 调用),但 stealth/ox-alpha 是强制深度推理的 stealth 模型,glm-5v-turbo 与 kimi-k3 的推理行为未特别配置——输出风格与推理深度可能天然不同。这是解读对比结果时要注意的局限,不是哪一方「作弊」。(与 三模型对比总览页的说明一致。)
在 n=1 的演示样本上,三个模型都出乎意料地稳:脏图(噪点+模糊+灰暗底)上三个字段全部读对、零编造、零过度拒识,四维得分完全相同、全部满分(各折合 100/100)——分数在这个样本上拉不开差距。可观察的差异都在行为细节:① glm-5v-turbo 是唯一输出格式不稳的一家——clean 臂带 ```json 围栏、dirty 臂为裸 JSON,内容等价但两臂不再逐字一致(ox-alpha 与 kimi-k3 两臂均逐字一致);② 推理开销梯度明显:kimi-k3 的 reasoning tokens 占 completion 比例最高(A 臂 306/342 ≈ 90%),glm-5v-turbo 次之(151/202),ox-alpha 报告为 0;③ 但两点必须如实说明:dirty.png 人眼仍可辨认全部字段,属「轻度退化」样本,远未达到证据锚点里 VLM-RobustBench「几何类扰动最高掉 34 个百分点」的强度;真值中不存在「不可读字段」,主指标「脏图编造率」没有被真正考验——三家都答对了所有可读字段,但都从未面对「该拒识却想猜」的诱惑。单例满分 ≠ 横评结论。