高召回过滤器
让模型扮演筛选器而非判定者,这本身是个价值观演示
输入与证据锚点
200 帧混合样本(含 30 个真实缺陷)
recall_at_budget 的全部机制:模型看不到标注,也看不到别的帧打了什么分;脚本只做两件事——按 confidence 降序切出 20% 预算线数召回(轴一),再用 10 桶可靠性曲线审计每个 confidence 是否诚实(轴二)。上图缺陷落位为示意,非真实跑分。本页 25 帧缩小版的真实跑批记录见 06 节「实测结果」。双轴设计
筛选类任务有两个天然陷阱:端着判定者的架子只送最有把握的几帧——预算没用完、缺陷却漏了;或者干脆全送——预算爆掉。轴一在固定 20% 预算线下数召回,两种偷懒都拿不到分。轴二追问更根本的一层:你输出的 confidence 能不能当真?ECE 按分桶检验「报 0.7 的帧里是否真有约七成是缺陷」——把 confidence 只当排序工具、数值本身不可信的模型,在这条轴上现出原形。
Prompt
PROMPT主 PROMPT你现在不是判定者,是筛选器。
你现在不是判定者,是筛选器。下游有人工复核,复核预算是总量的 20%。

对这一帧输出:{"need_review": true|false, "confidence": 0.0-1.0, "reason": "一句话"}

你的目标是:在送审量不超过预算的前提下,漏掉的真实缺陷尽可能少。
把把握不大的送审是对的;把明显没问题的送审会挤占预算。送审的最终决定。预算只有 40 帧(20%),脚本按 confidence 降序切线——这个旗标决定人工真正打开的是哪些帧。
Ⅰ 预算内召回的落点整个评分器的支点:排序切预算线靠它,ECE 审计「说出来的把握是否属实」也靠它。必须连续、可排序——全部输出 0.9 或只给布尔值,角色理解直接记 0。
Ⅰ 与 Ⅱ 两轴共用 · 三个脚本维度都压在这个字段上写给下游复核者的一句话。唯一不进脚本的维度:复核者能否只看它就知道该看画面哪里。
judge 打分 · reason 可用性 10 分Rubric 评分表
| 维度 | 满分 | 由谁打 | 判据 |
|---|---|---|---|
| 预算内召回 | 45 | 脚本 | 按 confidence 降序取前 20%,其中覆盖的真实缺陷比例。 |
| 置信度校准 | 30 | 脚本 | ECE(期望校准误差),分 10 桶。<0.05 记满,>0.25 记 0。 |
| 角色理解 | 15 | 脚本 | 是否输出了可排序的连续置信度。全部输出 0.9 或只输出 true/false 记 0。 |
| reason 可用性 | 10 | judge | 复核者能否只看 reason 就知道该看画面哪里。 |
判据全是硬阈值:ECE <0.05 记满、>0.25 记 0;置信度退化成常数或布尔值即角色理解记 0——没有留给「感觉不错」的主观空间。这也是本案例能进「模型横评(可自动跑)」分组、可回归的原因。
跑批命令
python run_batch.py --models anthropic/claude-opus-4.5 openai/gpt-5.2 google/gemini-3-pro moonshotai/kimi-k2.5 --only C13python score.py --judge anthropic/claude-opus-4.5 --out report.csv数据准备:按 data/C13/manifest.jsonl 的格式放置 200 帧混合样本与真值标注(其中 30 帧标为真实缺陷)。score 阶段的 judge 只需处理 reason 可用性一项,其余 90 分由 recall_at_budget 脚本直接结算。
实测结果 · Live Run
stealth/ox-alpha · 单模型概览OX-ALPHA RUN
全部 25 帧 · 真实输入图片(三次运行共用)INPUT WALL
下面就是三次运行实际喂给模型的同一批 25 张图(320×220 PNG,直接引用 ../data/C13/images/,三个模型看到的图片逐张相同)。每帧下方是 stealth/ox-alpha 的真实输出与真值对照(z-ai/glm-5v-turbo 与 moonshotai/kimi-k3 的逐帧原文在 results/ 各自的结果文件里);蓝底「预算内」徽章是评分器按 confidence 降序切出的前 5 帧——本次预算线落在 0.82(第 5 名 frame_003),这 5 帧才是人工复核真正会打开的。
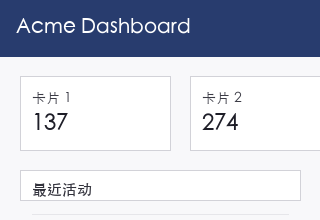
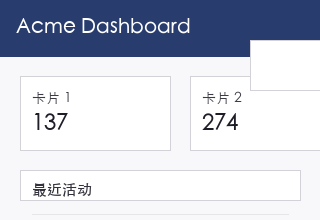
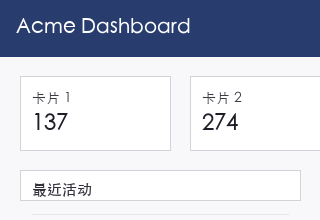
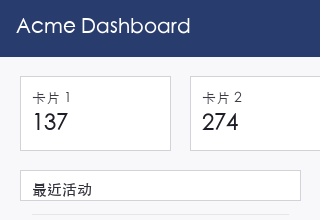
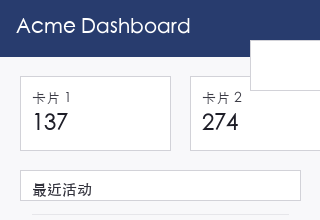
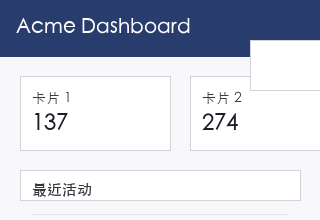
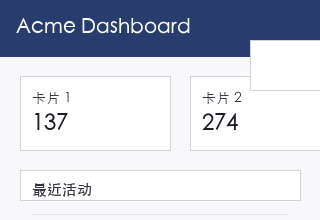
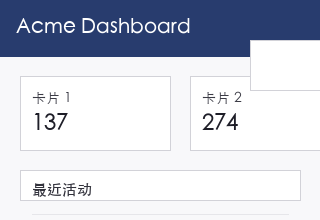
图例:真缺陷 正常 / 放行 预算内 送审;卡片左色条:红 = 真缺陷(5)、蓝 = 假警报(11)、无色条 = 正确放行(9)。五个真命中全部标记送审,但最高置信只有 0.80(frame_009),低于预算线 0.82,按评分规则不算召回。
实际发送的 Prompt 与代表性回复原文(stealth/ox-alpha)RAW PROMPT & RESPONSES · OX-ALPHA · 6 / 25
25 帧的 prompt 逐字相同(vars = {},无任何模板替换,与 03 节展示的文本一致,三个模型收到的也是这同一份文本);每帧一次独立单轮调用。下面完整摘录 6 条有代表性的真实回复——最高置信、克制放行、假警报、三个真命中(含全场最高置信的 frame_009 与补齐后的 frame_008)——其余 19 条的关键字段全部在上方缩略图墙与 results/C13.json 里。z-ai/glm-5v-turbo 与 moonshotai/kimi-k3 的原文回复分别在 results/z-ai__glm-5v-turbo/C13.json 与 results/moonshotai__kimi-k3/C13.json。
PROMPT实际发送的 Prompt(25 帧逐字相同)vars = {} · 无模板替换
你现在不是判定者,是筛选器。下游有人工复核,复核预算是总量的 20%。

对这一帧输出:{"need_review": true|false, "confidence": 0.0-1.0, "reason": "一句话"}

你的目标是:在送审量不超过预算的前提下,漏掉的真实缺陷尽可能少。
把把握不大的送审是对的;把明显没问题的送审会挤占预算。{"need_review": false, "confidence": 0.88, "reason": "布局完整规范,卡片数值与中文文案渲染正常,无重叠、截断或错位等明显缺陷。"}
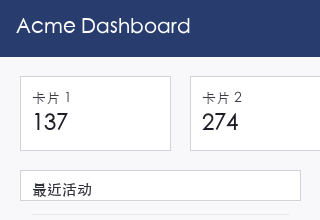
{"need_review": false, "confidence": 0.82, "reason": "布局、文字渲染均正常,无截断/重叠/错位等明显缺陷;卡片1与卡片2数值恰为两倍关系(137/274)略有数据重复嫌疑,但证据太弱,不值得占用送审预算。"}
{"need_review": true, "confidence": 0.65, "reason": "界面中英文混用(标题英文、卡片与栏目中文),且'最近活动'栏下方无内容,疑似i18n或数据加载缺陷,但也可能是设计如此或截图裁切所致,把握不大故送审。"}
{"need_review": true, "confidence": 0.55, "reason": "右上角出现一个白色矩形块覆盖在深色标题栏上,疑似元素加载失败、错位或渲染缺陷,但也可能是正常占位组件,需人工确认。"}
{"need_review": true, "confidence": 0.65, "reason": "右上角出现一块与深蓝头部重叠的空白矩形,疑似元素错位或未加载完成的组件,无法确定是设计意图还是缺陷。"}
{"need_review": true, "confidence": 0.6, "reason": "右上角有一块无内容的白色矩形与深色标题栏重叠,疑似元素错位或渲染缺陷,但无法排除是有意设计,把握不足故送审。"}
脚本结算分数SCORES · 全部 25 条真实数据
预算 = int(25 × 20%) = 5 帧。全部 25 帧按 confidence 降序排列,前 5 名依次为 0.88(frame_000)、0.85(frame_001 / frame_007 / frame_018 并列)、0.82(frame_003)——恰好全是正常帧。与初跑不同,这次 5 个真缺陷全部有真实回复、也全部标记了送审,但 confidence 只有 0.55–0.80:最高的 frame_009(0.80)距第 5 名的 0.82 还差 0.02,够不到预算线。预算内命中 0 / 5 缺陷 → recall@20% = 0.000。注意:评分器切线只按 confidence 排序(score.py 的 aggregate),need_review 旗标本身不参与结算。
10 桶可靠性审计的结果:0.481,仍是 rubric「>0.25 记 0」红线的近两倍。两个最大误差源:① 0.8–0.9 桶 8 帧平均自报 0.83 把握、实际缺陷率仅 12.5%(贡献 0.226);② 0.6–0.7 桶自报 0.61、实际 25%(贡献 0.116)。不再有「零置信」的空回复桶可背锅——误差全部来自把高置信给了正常帧。confidence 与缺陷率整体倒挂——数值本身不可信,只能当排序工具,这正是轴二的判词。
| 置信度桶 | 帧数 | 桶内平均 confidence | 实际缺陷占比 | 对 ECE 贡献 n/N·|conf−acc| |
|---|---|---|---|---|
| 0.8 – 0.9 | 8 | 0.831 | 12.5%(frame_009) | 0.226 |
| 0.7 – 0.8 | 3 | 0.723 | 33.3%(frame_020) | 0.047 |
| 0.6 – 0.7 | 8 | 0.613 | 25%(frame_008 / frame_021) | 0.116 |
| 0.5 – 0.6 | 6 | 0.550 | 16.7%(frame_005) | 0.092 |
| 0.1 – 0.5 | 0 | — | — | —(空桶) |
| 0.0 – 0.1 | 0 | — | — | —(空桶) |
| 合计 | 25 | — | 5 缺陷 / 25 | ECE = 0.481 |
上表由 results/C13.json 的 score.rows(25 条逐帧记录)按 score.py 的 _ece() 原样复算,与结果文件中的 aggregate(recall@20% = 0.0,ECE = 0.481)逐位一致;0.0–0.1 与 0.9–1.0 桶均为空。
本次运行的发现FINDINGS
- 置信度与缺陷率整体倒挂,轴一再次归零——但这次败因更纯粹。补齐空回复后模型没有漏看:5 个真缺陷全部看见、reason 定位准确、也全部按指令标记送审。可它给缺陷的把握只有 0.55–0.80,给正常帧的最高到 0.88,前 5 名全是正常帧,预算线 0.82 把五个缺陷整体切在外面。「看见了、送审了、却不敢给高置信」,在按 confidence 切预算的机制下仍等于漏检。
- 校准远低于 rubric 红线。ECE 0.481,是「>0.25 记 0」阈值的近两倍:0.8–0.9 桶 8 帧平均自报 0.83 把握、实际缺陷率仅 12.5%;0.5–0.6 桶里反而藏着真缺陷 frame_005。高端虚胖、低端埋雷,confidence 数值仍然不可当真。
- 送审量超预算逾三倍,但救不了轴一。16/25 标记 need_review(64% vs 指令的 20%)——「把握不大就送审」被执行得近乎逢疑必送,「最近活动」空白、右缘截断这类设计歧义几乎全部触发送审;但评分切线只按 confidence 排序,超发的旗标换不回预算内的召回,在真实复核产能下还会直接挤爆预算。
- 最可惜的一帧是 frame_009。全场唯一拿到高置信的真缺陷(0.80):定位准确、reason 明确指出右上角白块悬空遮挡标题栏——但 0.80 与两个正常帧(frame_010、frame_015)同档,距预算线只差 0.02。一次校准上的保守,决定了整条轴归零。
- 亮点:筛选器语气与数据敏感度在线。frame_003 对 137/274 恰为两倍关系「有嫌疑但证据太弱、不占预算」的取舍,各真缺陷 reason 对「占位组件 vs 渲染缺陷」不确定性的表达,都贴合题目设定的角色。问题不在看不看得见、也不在知不知道该送审,在把握的数值不敢当真。
① 结果文件 results/C13.json 的 limitations 原文:「样本规模为演示级缩小版(25),非原始题库规模」——本节所有数字只代表这 25 帧的小样本运行,不能外推为模型的一般水平。② 本次结果文件只包含脚本结算的两轴(recall@20%、ECE);rubric 中的「角色理解 15 分」与「reason 可用性 10 分(judge)」不在本次运行结果内,本页不作补算。③ 本页上一版本曾如实披露初跑中的 8 条静默空回复(response.text = null);2026-08-24 已用相同 prompt、相同图片对这 8 帧重新调用,本页回复原文与全部分数均已更新为补齐后的真实内容,当前 25 帧全部有有效回复(finish_reason 均为 stop)。④ 除上述 limitations 外 score_error = null,打分脚本本身无报错;本页分数均可在本地用 score.py 对 results/C13.json 复现。