按样例数符号
密集场景 + 相似干扰项,计数与标签必须同时正确
输入与证据锚点
图纸一张(电路图 / 管路图 / 地铁线路图 / 装配零件页)+ 一个符号的视觉样例
count / boxes 视觉相似但不同的干扰项,应写进 rejected 并说明区别 空白区报框=幻觉符号。示意图仅说明题型结构(密集小目标 + 相似干扰);本次实测的真实输入图片见 06 节 Live Run。
双轴设计
轴一落在 rubric 的「计数精确匹配 + 定位 IoU」,轴二落在「幻觉符号扣分」——同一个多余的框会让两轴同时受损。
Prompt
PROMPT主 PROMPT第一张图是一个符号的视觉样例。第二张图是一张图纸。
第一张图是一个符号的视觉样例。第二张图是一张图纸。

请在图纸中找出所有与样例相同的符号:
1. 总数;
2. 每一个的边界框(归一化坐标 [x0,y0,x1,y1]);
3. 另外单独列出你考虑过但排除掉的相似符号,说明它们与样例的区别在哪里。

计数和定位都必须正确。宁可少报一个也不要报一个不存在的。
输出 JSON:{"count": N, "boxes": [...], "rejected": [...]}{"count": N} — 与样例相同符号的总数;"boxes" — 每个命中的归一化边界框 [x0,y0,x1,y1];"rejected" — 考虑过但排除的相似符号,逐个写明区别。
评分刻意做成不对称:少报主要丢「计数精确匹配」的分;多报则每个不存在的框再扣 6 分、直接压高「幻觉符号数」这条轴——所以 Prompt 明文要求「宁可少报一个也不要报一个不存在的」。
Rubric 评分表
| 维度 | 满分 | 由谁打 | 判据 |
|---|---|---|---|
| 计数精确匹配 | 35 | 脚本 | count 与真值完全相等的样本比例。差一个即算错,不给部分分。 |
| 定位 IoU | 25 | 脚本 | 匹配框的平均 IoU(阈值 0.5 做匹配)。 |
| 幻觉符号 | 25 | 脚本 | 图纸中不存在的框,每个 -6。 |
| 干扰项辨析 | 15 | judge | rejected 列表是否真的对应图中存在的相似符号,且区别描述正确。 |
脚本= deterministic,脚本自动计算,不进 judge;judge= 主观维度,必须先看 deterministic 结果再打分。本案例总分归一化到 0-100。
跑批命令
python run_batch.py --models anthropic/claude-opus-4.5 openai/gpt-5.2 google/gemini-3-pro moonshotai/kimi-k2.5 --only C19python score.py --judge anthropic/claude-opus-4.5 --out report.csv数据准备:按 data/C19/manifest.jsonl 的格式放置图片与真值。score 阶段的 judge 只处理本案例 rubric 中非 deterministic 的维度。
实测结果 Live Run
以下是 2026-08-22 三次真实调用跑出的结果:stealth/ox-alpha、z-ai/glm-5v-turbo、moonshotai/kimi-k3 三个模型在同一套输入(同样三张图、逐字节相同的 Prompt,每家 n=2)上各自真实跑了一遍;输入图片、实际发送的 Prompt、模型原文回复与分数均逐字取自 data/C19/ 与 results/C19.json、results/z-ai__glm-5v-turbo/C19.json、results/moonshotai__kimi-k3/C19.json 的原始记录,未经润色或改写。样本规模为演示级(每模型 n=2,远小于原始题库设计),不构成有统计意义的横评结论。01–05 节是题目设计,本节才是真实跑出来的东西。另注:打分脚本曾因「多行内容塞进 JSON 字符串字段导致严格解析失败、被误判为未作答」的 bug 重算过分数,本页数值已与三个结果文件的当前内容(三者的 score_error 均为 null)逐格复核一致。
stealth/ox-alpha · z-ai/glm-5v-turbo · moonshotai/kimi-k3
样本规模每模型 n=2:2 张图纸(diagram_0 · diagram_1)+ 共用样例图
运行结果✓ 三模型均成功 —— 各自 2/2 请求返回,finish_reason=stop
输入一致性三家的图片列表与 Prompt 文本逐字节相同
✓ 2/2 · stop529 ×22443 / 3351usage 记 0$0✓ 2/2 · stop462 ×2501 / 1827339 / 1553$0.0104✓ 2/2 · stop534 ×26221 / 73635683 / 6733$0.2277真实输入图片
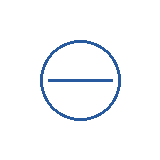
目标符号:蓝色圆内一条水平横线。两个样本共用这一张样例。
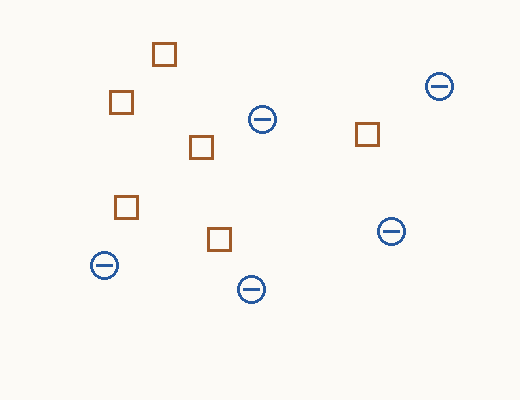
蓝色目标符号 ×5(与真值一致)+ 棕色空心方块干扰 ×6。
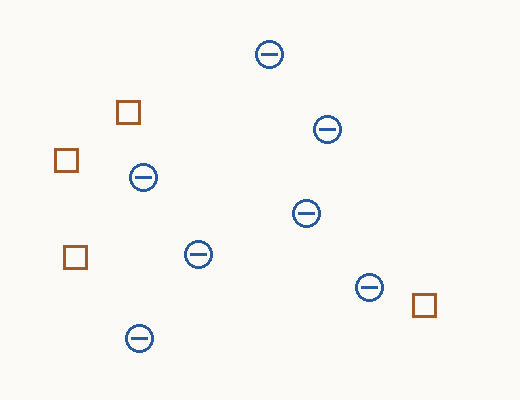
蓝色目标符号 ×7(与真值一致)+ 棕色空心方块干扰 ×4。
真值来自 data/C19/manifest.jsonl(truth.count:diagram_0 → 5、diagram_1 → 7),评分脚本据此对答案;发给模型的请求里只有上面三张图、不带任何标注——三个模型收到的图片列表完全相同,就是这三张。图中符号数量已按像素聚类复核(蓝 10/14 个连通域=5/7 组圆+横线,棕方块 6/4 个)。另注:本次实际使用的是程序绘制的符号散布图,并非题目设想的电路图/管路图等真实工程图纸——演示级缩水的另一处体现。
实际发送的 Prompt
PROMPTdiagram_0 · 唯一一轮随请求附带:exemplar.png + diagram_0.png
第一张图是一个符号的视觉样例。第二张图是一张图纸。

请在图纸中找出所有与样例相同的符号:
1. 总数;
2. 每一个的边界框(归一化坐标 [x0,y0,x1,y1]);
3. 另外单独列出你考虑过但排除掉的相似符号,说明它们与样例的区别在哪里。

计数和定位都必须正确。宁可少报一个也不要报一个不存在的。
输出 JSON:{"count": N, "boxes": [...], "rejected": [...]}
PROMPTdiagram_1 · 唯一一轮随请求附带:exemplar.png + diagram_1.png
第一张图是一个符号的视觉样例。第二张图是一张图纸。

请在图纸中找出所有与样例相同的符号:
1. 总数;
2. 每一个的边界框(归一化坐标 [x0,y0,x1,y1]);
3. 另外单独列出你考虑过但排除掉的相似符号,说明它们与样例的区别在哪里。

计数和定位都必须正确。宁可少报一个也不要报一个不存在的。
输出 JSON:{"count": N, "boxes": [...], "rejected": [...]}
两个样本在 manifest 中均为 vars = {}——没有任何占位符被替换,上框即逐字发送给模型的文本(与 03 节模板一致)。两条 Prompt 逐字节相同,差别只在附带的图纸;这一点对三个模型同样成立——三家请求的文本部分逐字节一致,随样本不同而不同的只有附带的图纸。
模型的真实原文回复
以下按模型分组。三家面对的是相同的两张图与相同的 Prompt(见 6.2),回复均逐字取自各自 results/*.json 的 response.text 字段,含代码围栏、换行与标点,未做任何排版整理或改写。
RESPONSEdiagram_0 · 原文count=5 ✓ 与真值一致 · completion 2443 tok
```json
{
  "count": 5,
  "boxes": [
    [0.80, 0.17, 0.86, 0.23],
    [0.47, 0.27, 0.53, 0.33],
    [0.72, 0.52, 0.78, 0.58],
    [0.18, 0.62, 0.24, 0.68],
    [0.45, 0.68, 0.51, 0.74]
  ],
  "rejected": [
    {
      "type": "brown_square",
      "reason": "形状为空心正方形而非圆形,颜色为棕色而非蓝色,且内部没有水平横线。",
      "boxes": [
        [0.28, 0.09, 0.34, 0.15],
        [0.20, 0.22, 0.26, 0.28],
        [0.37, 0.32, 0.43, 0.38],
        [0.21, 0.46, 0.27, 0.52],
        [0.39, 0.54, 0.45, 0.60],
        [0.67, 0.29, 0.73, 0.35]
      ]
    }
  ]
}
```RESPONSEdiagram_1 · 原文count=7 ✓ 与真值一致 · completion 3351 tok
```json
{
  "count": 7,
  "boxes": [
    [0.506, 0.108, 0.554, 0.168],
    [0.626, 0.295, 0.674, 0.355],
    [0.262, 0.415, 0.310, 0.475],
    [0.586, 0.503, 0.634, 0.563],
    [0.372, 0.608, 0.420, 0.668],
    [0.712, 0.690, 0.760, 0.750],
    [0.256, 0.820, 0.304, 0.880]
  ],
  "rejected": [
    {
      "box": [0.232, 0.250, 0.280, 0.310],
      "reason": "形状为正方形,颜色为棕色,且内部没有横线。"
    },
    {
      "box": [0.106, 0.370, 0.154, 0.430],
      "reason": "形状为正方形,颜色为棕色,且内部没有横线。"
    },
    {
      "box": [0.122, 0.615, 0.170, 0.675],
      "reason": "形状为正方形,颜色为棕色,且内部没有横线。"
    },
    {
      "box": [0.826, 0.733, 0.874, 0.793],
      "reason": "形状为正方形,颜色为棕色,且内部没有横线。"
    }
  ]
}
```两次请求均正常结束(finish_reason=stop)。以上为 stealth/ox-alpha 输出的逐字原样(含代码围栏、缩进与标点);token 数取自响应 usage 元数据。
RESPONSEdiagram_0 · 原文count=5 ✓ 与真值一致 · completion 501 tok(reasoning 339)
{"count": 5, "boxes": [[0.819, 0.262, 0.877, 0.354], [0.477, 0.342, 0.535, 0.435], [0.724, 0.609, 0.782, 0.702], [0.198, 0.697, 0.256, 0.790], [0.452, 0.763, 0.510, 0.856]], "rejected": [{"symbol": "棕色正方形", "reason": "形状为正方形而非圆形,且颜色为棕色而非蓝色。"}]}RESPONSEdiagram_1 · 原文count=6 ✗ 少报 1 个(真值 7) · completion 1827 tok(reasoning 1553)
```json
{
  "count": 6,
  "boxes": [
    [
      0.493,
      0.168,
      0.561,
      0.268
    ],
    [
      0.611,
      0.358,
      0.679,
      0.458
    ],
    [
      0.284,
      0.473,
      0.352,
      0.573
    ],
    [
      0.583,
      0.565,
      0.651,
      0.665
    ],
    [
      0.279,
      0.85,
      0.347,
      0.95
    ],
    [
      0.697,
      0.724,
      0.765,
      0.824
    ]
  ],
  "rejected": [
    {
      "description": "图纸中的四个棕色正方形",
      "reason": "这些符号的形状是正方形而非圆形,且颜色为棕色而非蓝色,内部也没有样例中的水平横线。"
    }
  ]
}
```两次请求均正常结束(finish_reason=stop)。以上为 z-ai/glm-5v-turbo 输出的逐字原样——diagram_0 的单行压缩 JSON 与 diagram_1 的带围栏展开 JSON 都是模型各自的原始排版;token 与成本数取自响应 usage 元数据。
RESPONSEdiagram_0 · 原文count=5 ✓ 与真值一致 · completion 6221 tok(reasoning 5683)
{"count":5,"boxes":[[0.817,0.183,0.871,0.253],[0.477,0.265,0.531,0.335],[0.725,0.543,0.779,0.613],[0.173,0.630,0.227,0.700],[0.458,0.688,0.512,0.758]],"rejected":[{"box":[0.294,0.108,0.340,0.168],"reason":"棕色空心方框:外形是正方形而非圆形,颜色为棕色,且没有贯穿中心的水平线。"},{"box":[0.212,0.228,0.258,0.288],"reason":"棕色空心方框:外形是正方形而非圆形,颜色为棕色,且没有贯穿中心的水平线。"},{"box":[0.685,0.308,0.731,0.368],"reason":"棕色空心方框:外形是正方形而非圆形,颜色为棕色,且没有贯穿中心的水平线。"},{"box":[0.365,0.340,0.412,0.400],"reason":"棕色空心方框:外形是正方形而非圆形,颜色为棕色,且没有贯穿中心的水平线。"},{"box":[0.219,0.490,0.265,0.550],"reason":"棕色空心方框:外形是正方形而非圆形,颜色为棕色,且没有贯穿中心的水平线。"},{"box":[0.400,0.570,0.446,0.630],"reason":"棕色空心方框:外形是正方形而非圆形,颜色为棕色,且没有贯穿中心的水平线。"}]}RESPONSEdiagram_1 · 原文count=7 ✓ 与真值一致 · completion 7363 tok(reasoning 6733)
{"count":7,"boxes":[[0.4923,0.1025,0.5462,0.1725],[0.6038,0.2900,0.6577,0.3600],[0.2500,0.4075,0.3038,0.4775],[0.5635,0.5000,0.6173,0.5700],[0.3558,0.6025,0.4096,0.6725],[0.6846,0.6825,0.7385,0.7525],[0.2423,0.8125,0.2962,0.8825]],"rejected":[{"box":[0.2250,0.2550,0.2673,0.3100],"reason":"棕色空心正方形;不是蓝色圆形轮廓,也没有居中水平线"},{"box":[0.1058,0.3750,0.1481,0.4300],"reason":"棕色空心正方形;形状和颜色均与样例不同,缺少圆形和水平线"},{"box":[0.1231,0.6175,0.1654,0.6725],"reason":"棕色空心正方形;无蓝色圆环和水平中线"},{"box":[0.7962,0.7375,0.8385,0.7925],"reason":"棕色空心正方形;轮廓为方形而非圆形,且没有水平蓝线"}]}两次请求均正常结束(finish_reason=stop)。以上为 moonshotai/kimi-k3 输出的逐字原样(单行压缩 JSON 为其原始输出格式,rejected 逐个给框且数量与图中方块一致:6、4);token 与成本数取自响应 usage 元数据。
真实计算出的分数 · stealth/ox-alpha 明细
1.00(2/2 全对)
定位IoU · 均值0.514
幻觉框 · 两图均值3 个/图
flagshallucinated_symbols ×2
n2
| 维度(脚本原值) | diagram_0 | diagram_1 | aggregate | 对照说明 |
|---|---|---|---|---|
| 计数精确 | 1.0 | 1.0 | 1.0 | count 与真值完全相等:5=5 ✓、7=7 ✓,不给部分分的硬维度全过。 |
| 定位IoU | 0.600 | 0.429 | 0.514 | 脚本原值 0.6 / 0.42857… / 0.514(见下方口径注)。 |
| 幻觉框 | 2 | 4 | 3 | 未匹配上的预测框数;两行 flags 均含 hallucinated_symbols。 |
表中数值为打分脚本写入 results/C19.json 的原值(显示时四舍五入到三位小数)。「干扰项辨析」维度属 judge 打分,本次实测的 score 里没有该维度,故不列、不估分。
口径如实注明:rubric 文案把「定位 IoU」定义为“匹配框的平均 IoU”,但两行原值恰等于命中比例(0.600=3/5、0.428571…=3/7)——该字段实际统计的是以 IoU≥0.5 判定为「匹配」的预测框占比,「幻觉框」即未匹配上的预测框数。页面按脚本原值呈现,特此说明与 rubric 措辞的出入。
3/5 个预测框匹配上(该行得分 0.600),其余 2 个未过 IoU≥0.5、计为幻觉框。
3/7 个预测框匹配上(该行得分 0.429),其余 4 个未过 IoU≥0.5、计为幻觉框。
蓝实线=真值框(manifest.jsonl 的 truth.boxes) 橙虚线=stealth/ox-alpha 的预测框(其回复中的 boxes)。对照图由本页按两侧坐标数据绘制,只为直观呈现差距,不改动任何分数。
- 计数满分:两图
count与真值完全相等(5、7)——“差一个即算错”的轴一硬维度全部拿下。 - 定位是短板:12 个预测框里 6 个卡在 IoU≥0.5 阈值之下(2/5、4/7),被记成幻觉框并打上
hallucinated_symbolsflag。但框位对照显示每个预测框附近都有真值符号、没有一个落在空白处——这里的“幻觉”主要是定位漂移(框没套准),不是无中生有;模型也没按 Prompt 要求“宁可少报”而少报。 - 干扰项辨析出乎意料地好(定性观察):两张图的棕色方块被全数放进了
rejected(6/6、4/4),区别理由正确(空心正方形 vs 圆+横线、棕色 vs 蓝色),且 rejected 给出的坐标与像素复核出的真实方块位置误差约 0.01–0.04——比它自己主列表里的框还准。该维度属 judge 判定,本次未打分,此处只是与图像复核结果的事实性对照。 - 局限(results/C19.json 的 limitations 原文):“样本规模为演示级缩小版(2),非原始题库规模”;输入也是程序绘制符号图而非真实工程图纸,结论不能外推到真实蓝图场景。
三模型同题对比
同一套图片、同一个 Prompt、同一套评分脚本:下面把三个模型在 C19 上的分数放到同一根轴上。色块即全站三模型图例( ox 蓝 · GLM 橙 · Kimi 青绿,与 compare.html 一致),数值均为各自 results/*/C19.json 中 score.aggregate 的原值。三个结果文件均正常产出可比分数(score_error=null),本案例不存在缺分项。
| 维度 × 样本(脚本原值) | stealth/ox-alpha | z-ai/glm-5v-turbo | moonshotai/kimi-k3 | 备注 |
|---|---|---|---|---|
| 计数精确 · diagram_0 | 1.0 | 1.0 | 1.0 | 三家都数对(真值 5)。 |
| 计数精确 · diagram_1 | 1.0 | 0.0 | 1.0 | GLM-5V 报 6、少报 1 个(真值 7),硬维度归零。 |
| 定位IoU · diagram_0 | 0.600 | 0.000 | 1.000 | 以 IoU≥0.5 判匹配:ox 3/5、GLM 0/5、Kimi 5/5。 |
| 定位IoU · diagram_1 | 0.429 | 0.000 | 1.000 | ox 3/7、GLM 0/6、Kimi 7/7。 |
| 幻觉框 · diagram_0 | 2 | 5 | 0 | 未匹配上的预测框数(每行 flags 同步记 hallucinated_symbols 与否)。 |
| 幻觉框 · diagram_1 | 4 | 6 | 0 | 同上。 |
| flags · aggregate | hallucinated_symbols ×2 | hallucinated_symbols ×2 | —(空) | aggregate.flags 原文:前两家两图均触发,Kimi K3 为空对象 {}。 |
方法论局限(沿用 compare.html 的口径):三个模型的调用方式相同(同一套 run_batch.py 风格的 OpenRouter chat/completions 调用),但 stealth/ox-alpha 是强制深度推理的 stealth 模型,glm-5v-turbo 与 kimi-k3 的推理行为未特别配置——输出风格与推理深度可能天然不同。这是解读对比结果时要注意的局限,不是哪一方“作弊”。
0/5 个预测框匹配上(该行得分 0.000):框都落在真实符号附近,但整体向下偏了大半个符号高度,全部未过 IoU≥0.5、计为幻觉框(5 个)——是定位漂移,不是无中生有。
5/5 个预测框全部匹配上(该行得分 1.000):预测框与真值几乎重合(差异在小数点后第二位),幻觉框 0。
count 只报了 6(真值 7):6 个预测框虽都在真实符号附近,却同样整体向下偏移、无一过 IoU≥0.5(得分 0.000 → 幻觉框 6);中部偏左下还有 1 个符号被漏数。
7/7 全部匹配上(得分 1.000)、count=7 正确、幻觉框 0 且无任何 flag——本案例唯一一个两图全绿的成绩。
蓝实线=真值框(manifest.jsonl 的 truth.boxes,与 6.1 / 6.4 同一来源) 棕橙虚线=z-ai/glm-5v-turbo 的预测框 青绿虚线=moonshotai/kimi-k3 的预测框。
对照图由本页按各 results/*.json 中两侧坐标数据绘制,只为直观呈现差距,不改动任何分数;stealth/ox-alpha 的同款对照已在 6.4 给出(其预测框沿用那里的橙红虚线样式——ox 的模型主题色恰与真值框同为蓝色,无法再用主题色区分预测框)。
- Kimi K3 在本案例全面领先:两图 count 全对、12/12 预测框全部匹配(定位 IoU 1.000)、幻觉框 0、flags 为空;代价是最长的输出(completion 6221 / 7363 tok,其中 reasoning_tokens 占 5683 / 6733)和最高的成本(每次 $0.1044 / $0.1233)。它的 rejected 也逐个给框、数量与图中方块一致(6、4),粒度最细。
- ox-alpha 输在定位精度而非找符号:计数满分,但 12 个框里 6 个差半口气没过 IoU≥0.5 阈值(IoU 0.514);对照图显示框位都在真实符号附近——与 GLM-5V 同属“找得到、套不准”,只是漂移幅度小得多。
- GLM-5V 的失败模式是系统性向下偏移:两图 IoU 均 0.000、11 个预测框无一过阈值,但框并非无中生有,而是整体落在真值下方约 0.02–0.09(归一化单位,多数 ≈0.08,恰是大半个符号高);diagram_1 还把 7 数成 6。它的 rejected 也最粗:两图各只写 1 条泛泛的「棕色正方形」,不带逐个坐标。
- 推理深度用量差异肉眼可见:usage 里 reasoning_tokens 为 Kimi K3 5683 / 6733、GLM-5V 339 / 1553、ox-alpha 该字段记 0(其推理不在该字段反映)。本案例里推理用量与定位质量同向,但 n=2 支撑不了因果结论。
- 口径提醒(同 compare.html):样本为演示级 n=2、输入是程序绘制的符号散布图而非真实工程图纸,上述差异不构成有统计意义的横评结论。