两个模型对着一张棋盘下棋
看错棋盘导致的连锁崩溃,比任何分数都直观
输入与证据锚点
实拍棋局照片(国际象棋 / 五子棋 / 象棋),含反光、斜角、部分遮挡
双轴设计
Prompt
共 3 步:TURN 1 是发给模型的唯一文字 PROMPT(随开局照片发出);TURN 2–3 是对弈循环里由执行器与打分脚本接手的环节,不新增指令文字。
TURN 1/3主 PROMPT开局随图发出这是当前棋局的实拍照片。轮到你走。
这是当前棋局的实拍照片。轮到你走。

每一步必须严格按顺序输出:
1. board:你读到的完整棋盘状态(国际象棋用 FEN,其他用等价的结构化表示);
2. legal_moves:你认为当前所有合法走法中最好的三个;
3. move:你的走法;
4. 如果你发现照片中有你无法确认的格子,在 uncertain 里列出,不要凭空补子。

输出 JSON。走完后你会收到执行你走法后的新照片。
TURN 2/3对弈循环执行器接手执行器把 move 应用到真实棋盘,拍下新照片作为下一条消息回传。
脚本核验该手 move 可执行后,把它应用到真实棋盘上,再拍摄新照片回传——正如主 PROMPT 结尾所写:「走完后你会收到执行你走法后的新照片」。此后每一手都是同一循环:新照片 → 同一份四段协议输出 → 走子 → 新照片,全程不再追加任何文字指令。self_play_pair 下两名模型在同一个真实棋盘上轮流执子,谁的手都逃不过同一套读盘协议。
TURN 3/3逐步计分scorer:game_state每一手的 board 声明都与真实棋盘逐格比对,跨手追踪是否自我纠正。
每一手落子后,game_state 把该手声明的 board 与真实棋盘逐格对照(棋盘识别),并核对 move 相对真实棋盘的合法性(而非相对它自己读到的棋盘);同时跨手追踪:一旦某手读错,后续各手是纠回真实状态还是沿着错误状态继续推演(后者「崩溃恢复」记 0);最后检查被遮挡的格子是标了 uncertain 还是凭空补了子。
两名模型在同一张真实棋盘上轮流执子:一手走完,执行器就把新局面拍成照片交给对手。于是每一手都同时产出两轴数据——board 读得准不准(轴一),读错之后能不能回到真实状态(轴二)。
Rubric 评分表
| 维度 | 满分 | 由谁打 | 判据 |
|---|---|---|---|
| 棋盘识别 | 40 | 脚本 | 逐格比对准确率。整盘完全正确的比例单独报。 |
| 走法合法性 | 25 | 脚本 | 相对于真实棋盘(而非它读到的棋盘)的合法率。 |
| 崩溃恢复 | 25 | 脚本 | 一旦某步棋盘读错,后续步骤中是否自行纠正回真实状态。持续沿着错误状态推演 → 记 0。 |
| uncertain 使用 | 10 | 脚本 | 遮挡格子是否标 uncertain 而非凭空补子。 |
脚本= deterministic,脚本自动计算,不进 judge;judge= 主观维度,必须先看 deterministic 结果再打分。本案例总分归一化到 0-100。
跑批命令
python run_batch.py --models anthropic/claude-opus-4.5 openai/gpt-5.2 google/gemini-3-pro moonshotai/kimi-k2.5 --only C20python score.py --judge anthropic/claude-opus-4.5 --out report.csv数据准备:按 data/C20/manifest.jsonl 的格式放置图片与真值(棋类 / 真实 FEN 或等价结构化真值)。score 阶段的 judge 只处理本案例 rubric 中非 deterministic 的维度——本案四维全部为脚本自动计算。
实测结果 Live Run
2026-08-22 / 08-23 · 三模型真实运行成功以下是三个模型各自真实调用(OpenRouter)跑出的结果:stealth/ox-alpha(2026-08-22)、z-ai/glm-5v-turbo(2026-08-23 20:52)、moonshotai/kimi-k3(2026-08-23 21:29),三次均由同一 harness 循环 harness/run_all.py · run_c20 执行。三者面对的开局相同(1.e4 e5 2.Nf3 Nc6 3.Bb5)、发送的 Prompt 逐字相同,PLY 0 照片为确定性渲染(同一局面 + 同一 seed)——故 PLY 0 三个模型的输入完全一致。各模型的回复原文与分数逐字取自 results/C20.json、results/z-ai__glm-5v-turbo/C20.json、results/moonshotai__kimi-k3/C20.json,未做润色或改写。样本规模为演示级——各自对弈 2 手(远小于原始题库设计;limitations 原文:「样本规模为演示级缩小版(custom),非原始题库规模」)。三次运行全部成功,不存在任何 C20.error.log。
三处与题目设计的差异,如实标注而非掩盖:① 题面写「实拍棋局照片」,harness 实际用的是脚本渲染的 480px 棋盘图再叠加退化(旋转 / 噪声 / 模糊 / 偏暗 / JPEG 压缩,见各手图注),并非相机实拍;② 原设计为「两名模型配对轮流执子」,三次演示均为同一模型自对弈两手;③ 自 PLY 1 起三个模型的输入不再相同——各自的 PLY 0 走法决定了自己 PLY 1 面对的局面(GLM-5V 的 d4 被执行器拒收,局面原样重拍),因此 PLY 1 是「各做各的第二手」,不是同一输入的横评。另注:runs_tmp/c20_ply{0,1}.jpg 是固定路径、每次运行覆写(harness/run_all.py:288),当前磁盘上的 PLY 1 文件是 Kimi K3 运行留下的,ox-alpha 与 GLM-5V 的 PLY 1 照片已被覆盖(详见 PLY 1 区块图注)。
方法论局限(沿用三模型对比页的说明):三个模型的调用方式相同(同一套 run_batch.py 风格的 OpenRouter chat/completions 调用),但 stealth/ox-alpha 是强制深度推理的 stealth 模型,glm-5v-turbo 与 kimi-k3 的推理行为未特别配置——输出风格与推理深度可能天然不同。这是解读对比结果时要注意的局限,不是哪一方「作弊」。
这是当前棋局的实拍照片。轮到你走。

每一步必须严格按顺序输出:
1. board:你读到的完整棋盘状态(国际象棋用 FEN,其他用等价的结构化表示);
2. legal_moves:你认为当前所有合法走法中最好的三个;
3. move:你的走法;
4. 如果你发现照片中有你无法确认的格子,在 uncertain 里列出,不要凭空补子。

输出 JSON。走完后你会收到执行你走法后的新照片。
run_c20 对每个模型的每一手均发送同一份 case["prompt"] 文本(与 03 节 TURN 1 逐字一致),各自与当轮照片组成一条 user 消息发出;除此之外全程无其他文字指令。三个模型唯一的差别是 MODEL 本身——无任何按模型定制的提示词或参数。
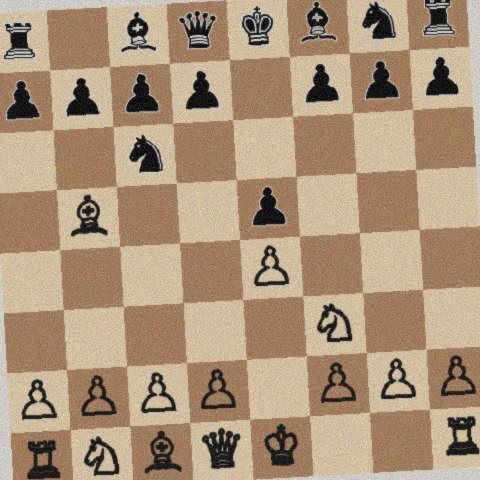
runs_tmp/c20_ply0.jpg —— 脚本渲染 480px 棋盘后施加 degrade(rotate=4, noise=10, blur=0.6, brightness=0.9, jpeg_q=60, seed=20),再以 quality=85 存盘。渲染只依赖局面与 seed、与模型无关,故三个模型在 PLY 0 看到的是同一张图。```json
{
"board": {
"fen": "r1bqkb1r/pppp1ppp/2n5/1B2p3/4P3/5N2/PPPP1PPP/RNBQK2R b KQkq - 1 3",
"description": "西班牙开局:1.e4 e5 2.Nf3 Nc6 3.Bb5 之后,轮到黑方",
"side_to_move": "black"
},
"legal_moves": [
{"san": "Nf6", "note": "主流应着,出子带攻击(瞄 e4),进入柏林/古典变例"},
{"san": "a6", "note": "莫菲防御,立即追问 b5 象,逼其表态"},
{"san": "d6", "note": "稳健封闭中心,保留多种布局选择"}
],
"move": {
"san": "Nf6",
"uci": "g8f6",
"reason": "最自然的出子:同时攻击 e4 白兵,保持局面弹性,是此局面公认最强应手之一"
},
"uncertain": [
"b5: 照片中该象渲染偏深色,但按合法性推断必为白方象(黑方双象仍在 c8/f8,且黑象无法合法到达 b5),已按白象处理",
"h1: 底边右侧车在照片中较暗、部分贴近边缘,按完整初始配置判定为白车在场",
"回合数/半回合计数(1 3)为根据局面反推,照片本身不含计时或着法记录信息"
]
}
```
判错原因:声明的 FEN 第 8 横线是 r1bqkb1r,漏掉了 g8 的黑马(真实为 r1bqkbnr);此外它把半回合计数写成 1(真实为 3,整回合数 3 一致——计数段不在计分比对范围内)。计分脚本只逐格比对子力布置段 → 不一致。
```json
{
  "board": "r1bkqbnr/pppp1ppp/2n5/4p3/1b6/4P1N2/PPPP2PP/RNBQK2R w KQkq - 2 5",
  "legal_moves": ["d4", "O-O", "c3"],
  "move": "d4",
  "uncertain": []
}
```
整盘幻觉:声明的是一个不存在的局面——黑象凭空出现在 b4、白兵从 e4 挪到 e3、d8/e8 王后互换、行棋方写成白方、计数写成「2 5」(真实为黑方行棋、计数「3 3」)。走法 d4 是白方走法,黑方回合不可走 → 执行器拒收、未应用,PLY 1 只能原样重发同一局面。uncertain 为空数组。
```json
{
  "board": "r1bqkbnr/pppp1ppp/2n5/1B2p3/4P3/5N2/PPPP1PPP/RNBQK2R b KQkq - 3 3",
  "legal_moves": ["a6", "Nf6", "Bc5"],
  "move": "a6",
  "uncertain": []
}
```
声明的 FEN 与真实局面逐字符一致(含「- 3 3」计数段);走法 a6 合法并被执行器应用。输出协议为最简扁平结构:board 直接给 FEN 字符串、legal_moves 为纯 SAN 数组。
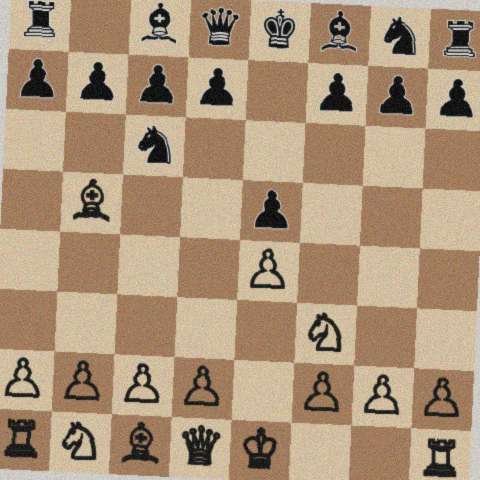
runs_tmp/c20_ply1.jpg 当前的内容:Kimi K3 运行(08-23 21:26 写入)PLY 1 实际看到的画面——黑方 a6 之后、轮白方,degrade(..., seed=21)。run_c20 每次运行覆写同一路径(harness/run_all.py:288),故 ox-alpha(08-22 · Nf6 之后)与 GLM-5V(08-23 · d4 被拒收、开局局面原样重拍)的 PLY 1 照片已不在磁盘上;三者的真实局面以下方各卡所列 real_fen_before 为准。真实局面(走子前):r1bqkb1r/pppp1ppp/2n2n2/1B2p3/4P3/5N2/PPPP1PPP/RNBQK2R w KQkq - 4 4(自己 PLY 0 的 Nf6 之后)
```json
{
  "board": {
    "fen": "r1bqkb1r/pppp1ppp/2n2n2/1B2p3/4P3/5N2/PPPP1PPP/RNBQK2R w KQkq - 4 4",
    "description": "西班牙开局(Ruy Lopez):1.e4 e5 2.Nf3 Nc6 3.Bb5 Nf6 之后,轮到白方。双方子力齐全,白方 f1/g1 已空出(象去 b5、马去 f3),黑方 e 兵在 e5。"
  },
  "legal_moves": [
    { "move": "O-O", "san": "王翼易位", "reason": "立即获得王的安全,保持局面弹性,是最稳健的主流选择" },
    { "move": "d3", "san": "d2-d3", "reason": "巩固 e4 兵,为后续发展留空间,现代封闭式西班牙的常见走法" },
    { "move": "Nc3", "san": "马b1-c3", "reason": "继续出子,转入四马变例,局面自然" }
  ],
  "move": "O-O",
  "uncertain": [
    {
      "square": "b5",
      "note": "照片中该象的颜色渲染偏暗、不易直接分辨;但逻辑上可确定它是白方象:若为黑方,则黑方将同时拥有 c8、f8、b5 三个象且白方 f1 象凭空消失,与当前无吃子、无升变的子力总数矛盾。故按白方 Bb5 处理(即标准 3.Bb5)。"
    }
  ]
}
```
声明的 FEN 与真实局面逐字符一致(含「- 4 4」计数段)。执行器应用 O-O 后本次 2 手循环结束。
真实局面(走子前):r1bqkbnr/pppp1ppp/2n5/1B2p3/4P3/5N2/PPPP1PPP/RNBQK2R b KQkq - 3 3(d4 被拒收,局面与 PLY 0 相同、原样重拍)
```json
{
  "board": "rnbqkbnr/pppp1ppp/2n5/1B2p3/4P3/5N2/PPPP1PPP/RNBQK2R b KQkq - 4 3",
  "legal_moves": [
    "a6",
    "Nf6",
    "d6"
  ],
  "move": "a6",
  "uncertain": [
    "b8",
    "g8",
    "g1"
  ]
}
```
面对原样重拍的同一局面,声明仍写成 rnbqkbnr——b8 黑马凭空回位(漏掉已到 c6 的马)。微妙之处:它 uncertain 恰恰列了 b8/g8/g1 三格,却仍按初始配置把马照填回去——「标了不确定又自行补子」。走法 a6 这次合法并被应用。两手均读错、始终未纠回 → 崩溃恢复记 0。
真实局面(走子前):r1bqkbnr/1ppp1ppp/p1n5/1B2p3/4P3/5N2/PPPP1PPP/RNBQK2R w KQkq - 0 4(自己 PLY 0 的 a6 之后——即上方照片所示局面)
{
  "board": "r1bqkbnr/1ppp1ppp/p1n5/1B2p3/4P3/5N2/PPPP1PPP/RNBQK2R w KQkq - 0 4",
  "legal_moves": ["Ba4", "Bxc6", "Bc4"],
  "move": "Ba4",
  "uncertain": []
}
声明的 FEN 再次与真实局面逐字符一致(含「- 0 4」计数段);走法 Ba4 合法并被执行器应用。注意原文这次连 ```json 围栏都省了(直接输出裸 JSON,仍被解析成功)——协议形状在两手间亦有漂移。
| 维度(Rubric) | 满分 | ox-alpha | GLM-5V | Kimi K3 | 判定依据(逐模型,取自各自 JSON) |
|---|---|---|---|---|---|
| 棋盘识别 | 40 | 0.5 | 0.0 | 1.0 | ox:2 手中 1 手整盘正确(PLY 1;PLY 0 漏 g8 黑马)→ score["棋盘识别"] = 0.5。GLM:两手均错(PLY 0 整盘幻觉、PLY 1 漏 c6 马)→ 0.0。Kimi:两手逐字符全对 → 1.0。 |
| 走法合法性 | 25 | 1.0 | 0.5 | 1.0 | ox:Nf6、O-O 均 2/2 合法并被应用 → 1.0。GLM:PLY 0 的 d4 相对真实棋盘非法、被拒收,PLY 1 的 a6 合法 → 0.5。Kimi:a6、Ba4 均 2/2 合法并被应用 → 1.0。 |
| 崩溃恢复 | 25 | 1 | 0 | 0 | 口径=「上一手读错、下一手纠回」的次数。ox:PLY 0 读错 → PLY 1 纠回真实局面,记 1。GLM:两手均读错、始终未纠回 → 0。Kimi:全程未读错、没有可计的恢复事件 → 0——此 0 是「无事可恢复」,与 GLM 的「崩溃后未恢复」含义不同,解读时勿混。 |
| uncertain 使用 | 10 | 未输出 | 未输出 | 未输出 | 三个模型的运行脚本均未计算该维度——三份 JSON 的 item score 中都无此键,页面如实留空,不作估算。(各家 PLY 0/1 的 uncertain 字段原文见上方实录:ox 两手均有实质标注;GLM 一空一非空但照填;Kimi 两手均为空数组。) |
分数逐字取自 results/C20.json、results/z-ai__glm-5v-turbo/C20.json、results/moonshotai__kimi-k3/C20.json 的 run.items[0].score;三家 flags 均为 []、顶层 "score" 均为 null(harness 设计所致——本案例分数直接写入 item)、score_error 均为 null(打分无报错)。与单模型版一致,未做 40/25/25/10 加权归一到 0–100 的总分计算,故不呈现总分。每模型 n=1 局 2 手,演示级样本,只看方向不排名。
Kimi K3(棋盘识别 1.0)是三者中唯一两手 board 全对的:两张 FEN 都与真实局面逐字符一致(连计数段都对),输出协议也最简(board 直接给 FEN 字符串、legal_moves 为纯 SAN 数组)。但要注意:它全程没读错,崩溃恢复记 0 是「没有可计的恢复事件」,不是「崩溃后没恢复」——与 GLM-5V 的 0 含义完全不同。
ox-alpha(棋盘识别 0.5)是唯一触发「读错 → 自纠」链路的:PLY 0 声明的 FEN 漏掉 g8 黑马,可它选的走法恰恰是把这匹马跳到 f6(g8f6)——「知道」马在 g8、逐格转写时漏写;真正出错的 g8 没标 uncertain,标出来的 b5/h1 反而都判对了。PLY 1 完全纠回(FEN 逐字符一致,并走出合法王翼易位)→ 崩溃恢复记 1。题目最想抓的「沿错误状态一路推演」在它身上没有发生。
GLM-5V(棋盘识别 0.0)是三者中唯一整盘幻觉的:PLY 0 声明了一个不存在的局面(黑象凭空出现在 b4、白兵挪到 e3、王后互换、行棋方与计数全错),并走出对黑方非法的 d4 被执行器拒收;PLY 1 面对原样重拍的同一局面,又把 b8 马写回初始位——uncertain 里明明标了 b8/g8/g1 却仍照初始配置补子。两手均读错、零纠正:它的崩溃恢复 0 才是本案例设计里要抓的那种失败。
协议形状三家三种风格:ox 的嵌套对象+长注释(且两手 legal_moves 字段结构不一致:{san, note} vs {move, san, reason})、GLM 的扁平字符串、Kimi 的扁平字符串(PLY 1 连 ```json 围栏都省了)。这与「ox-alpha 强制深度推理、另两家未特别配置推理行为」的已知局限一致——输出深度/风格天然不同,横向比较风格意义有限;而分数口径(逐格比对、相对真实棋盘的合法性、恢复计数)对三家完全一致,可比的是分数而不是文风。