总览 / 微表情 Demo
EXTRA DEMO · VIDEO MICRO-EXPRESSION
视频微表情 / 面部动作识别
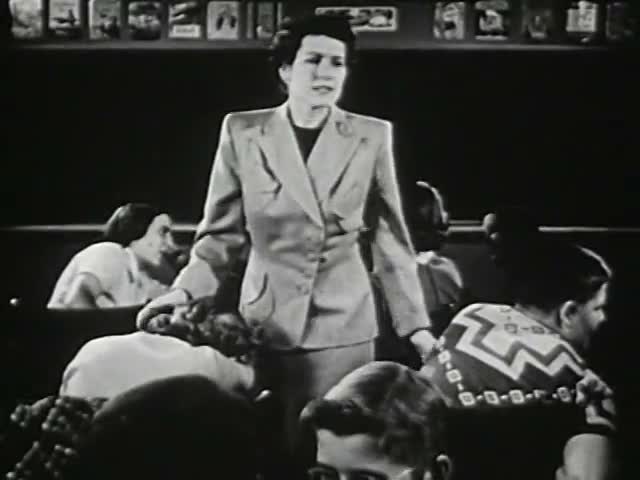
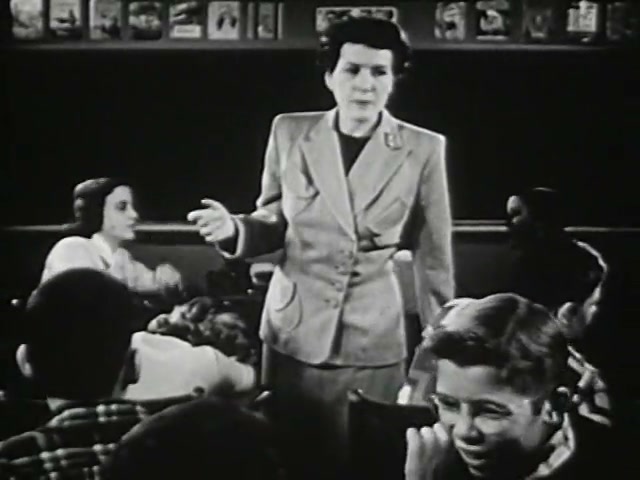
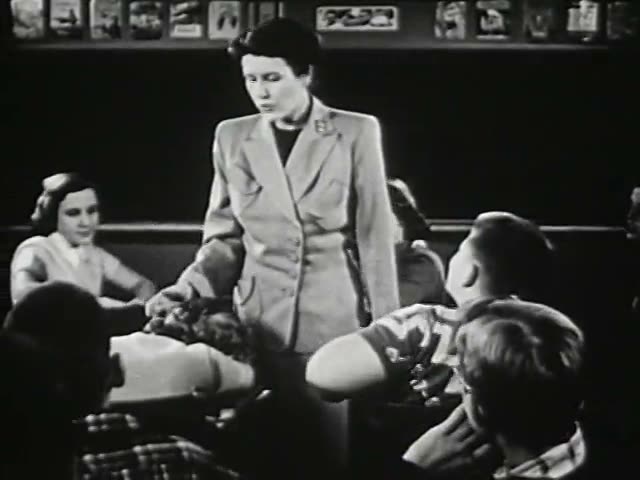
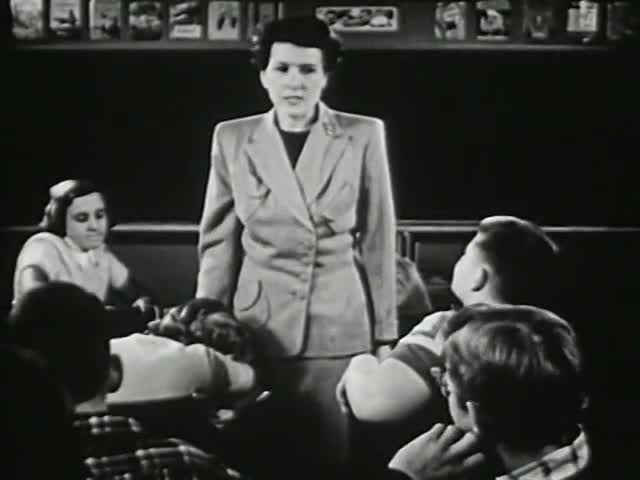
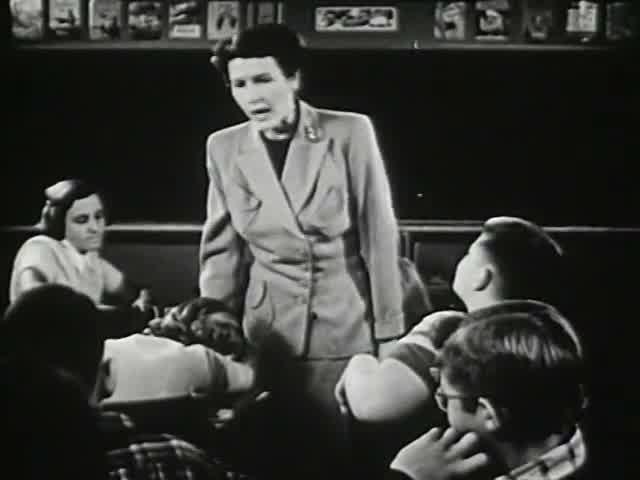
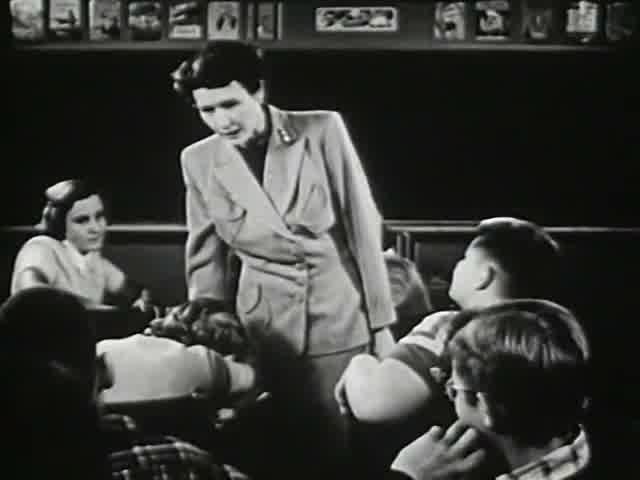
从 Internet Archive(Prelinger Archives)收藏的 1951 年美国教育短片《The Other Fellow’s Feelings》(公共领域)里截取连续 12 秒,按 0.5fps 等间隔采样出 6 帧,真实调用一次 stealth/ox-alpha 做面部动作 / 表情分析。本页原样展示那次调用发出的 Prompt 和模型返回的逐字原文——包括它给每条观察自行标注的【可靠】【弱证据】【推测】,以及它主动写下的「这不是读心术」式边界声明。
Model stealth/ox-alphaProvider OpenRouter输入 6 帧 · 0.5fps · 640×480片段 00:46–00:58调用 single call · 7,350 tok · $0License Public Domain (CC0)
这个 demo 的素材先天就撑不起「微表情识别」四个字:每 2 秒才采一帧(真正的微表情研究通常需要 25fps 以上);1950 年代黑白胶片翻拍,人脸在 640×480 画面里只占几十像素高;而且片中「老师」是演员按剧本表演,不是自发的真实情绪。在这样的输入上,任何模型能可靠看出的也只有「她在第几秒低头、前倾、张大了嘴」这个量级的事实。
更根本的一条:表情和情绪之间只是统计上的倾向性关联,不是可以逐条翻译的词典。无论 AI 还是人,都无法从这 6 帧里读出「她的真实感受」,更不能据此判断谁在说谎。模型在下面的回复里也自己用了整整三节(第 0、3、5 节)来说明同一件事——那部分话,比它的任何一条「分析」都更值得当真。
01
源素材与采样
源视频 SOURCE VIDEO
《The Other Fellow’s Feelings》
1951 · SOCIAL GUIDANCE FILM
美国教育短片,讲述嘲笑 / 奚落带来的伤害;1950 年代经典社会指导片(social guidance film)。画面中的「老师」由演员按剧本表演——这一点模型在回复第 3 节里也专门指了出来。
截取与采样 CLIP & SAMPLING
片段窗口 源片 00:46–00:58 ,连续 12 秒
采样率 0.5fps 等间隔 → 每 2 秒 1 帧,共 6 帧
分辨率 640×480,黑白胶片翻拍
性质说明 摆拍表演素材(非自发真实表情),本质上有别于微表情研究的对象
03
实际发送的 Prompt 真实发出的完整 Prompt 原文(results/microexpr.json → prompt_sent),未做删改。注意:其中只要求模型「分清可靠证据与纯属推测」,并没有规定任何标签体系。
SENT 完整 Prompt(原文) 4 项分析要求,其中第 3、4 条是预先写入的能力边界约束
以下是一段 1951 年美国教育短片《The Other Fellow's Feelings》(公共领域)里连续约 12 秒的画面,等间隔采样出 6 帧,顺序播放。画面中站立说话的成年女性(老师)面对镜头,正在对坐着的孩子们说话。

请对这段序列做面部表情/微表情分析,要求:
1. 逐帧描述她可观察到的面部动作(不是笼统的"生气""开心"这种,尽量用具体的面部部位变化来描述,比如眉毛位置、嘴角、下巴、眯眼程度等);
2. 指出整个序列里表情变化最明显的转折点,说明是从什么状态变化到什么状态;
3. 明确说明:这是稀疏采样(约0.5fps)、且是 1950 年代 640x480 黑白胶片翻拍视频,分辨率和帧率都远达不到真正微表情研究(通常需要 25fps 以上)的要求,所以你的判断的可信度上限在哪里,哪些判断纯属你的推测而非可靠证据;
4. 不要输出"这个人在说谎""这个人真实感受是xxx"这类下定论的读心式结论——你只能描述可观察到的面部动作证据,以及这类动作在表情研究文献里"通常"(不是"一定")与什么心理状态有关联,两者要分清楚。

最后输出一段简短总结:如果要用这段素材做一个"AI 微表情识别"的科普/演示网页,你会怎么向读者说明这个演示的能力边界,避免读者误以为这是可靠的读心术或测谎仪。
04
模型真实回复(逐字原文) 编辑注 · 站点所加,非模型文字 以下是 stealth/ox-alpha 对这 6 帧返回的逐字原文 ——没有摘要、没有改写、没有截断;页面上做的唯一加工,是给文中的置信度标签加了配色(图例见下),并在本节末尾附了可展开的 Markdown 原文视图以便逐字核对。两点值得留意:① 【可靠】【弱证据】【推测】这套三级标注体系是模型自己设计的,Prompt 并未规定格式;② 第 0 节「分析前的必要声明」、第 3 节「可信度上限」、第 5 节「如何向读者说明能力边界」都是它主动写的,不是站点诱导出来的。
【可靠】 ×12 大尺度、可直接观察的变化(头部姿态、朝向、嘴部开闭、大幅手势)【弱证据】 ×8 有观感线索但无法排除光照 / 颗粒干扰(含【弱证据/不可判】【弱证据,倾向推测】两条组合标签)【推测】 ×2 超出画面证据的解读
面部/头部动作逐帧分析(附可信度说明)
0. 分析前的必要声明
以下所有观察基于 6 张间隔约 2 秒的静态帧。她的脸部在 640×480 画面中大约只占 60–80 像素高,且为黑白胶片翻拍——这个条件下只能可靠观察大尺度的头部姿态、朝向、嘴部开闭 ;眉毛、眼睑、嘴角的细微形态只能给出“疑似”级别的描述。我在每条后面标注了置信度:【可靠】 /【弱证据】 /【推测】
1. 逐帧观察
帧1(0.0s)
头部直立,基本朝向正前方(全班方向)【可靠】
嘴张开,处于发声状态;开口幅度中等【可靠】
眉区亮度大致均匀,看不出明显抬眉或压眉——但无法排除是胶片反光【弱证据/不可判】
双手自然下垂于身体两侧【可靠】
帧2(2.0s)
右臂抬至胸腹高度,掌心向下做下压/示意类手势【可靠】 ——这是身体层面的强调信号
嘴张开,开口比帧1略大,下颌下降明显【可靠】
头部仍直立朝前;额头区域显得比帧1略亮,可能 是抬眉,但也可能只是头部角度变化导致的光照变化【弱证据】
眼睛睁开程度中等【弱证据】
帧3(4.0s)
头部明显低下、前倾,视线方向从“面向全班”转为朝向正前方/下方近处的学生 【可靠】 ——这是本序列中最清晰的姿态变化嘴部看起来接近闭合或微张【弱证据】
下颌略内收【弱证据】
帧4(6.0s)
头部回到近水平位置,重新面向前方【可靠】
嘴张开,说话中【可靠】
上眼睑区域看起来比帧1–2更“收紧”,眉区显得略低——若属实,近似 FACS 中的 AU4(皱眉)+ AU7(眼睑收紧)组合,但在这个分辨率下无法与阴影、胶片颗粒区分 【弱证据,倾向推测】
帧5(8.0s)
嘴开口幅度为全序列最大之一,符合重读/强调某个词时的口腔形态【可靠】
头部略前倾【可靠】
眉/眼区域的“收紧感”延续帧4的观感【推测】
注意:嘴张大本身主要是说话动力学 (音量、元音开口度),不能直接当作情绪证据
帧6(10.0s)
身体和头部明显前倾、低头,朝向近处的学生 【可靠】 ——与帧3类似的“指向个别学生”姿态,且幅度更大嘴部形态像发声中或抿住,帧内无法确定【弱证据】
前景学生的头部转向她,属于语境信息(互动对象明确化),不是她的面部动作
2. 最明显的转折点
帧2 → 帧3(约 2–4 秒) :从“直立、面向全班、伴随抬手下压手势的整体讲话模式”,转为“低头、前倾、视线指向近处个别学生”的模式。这是全序列置信度最高的变化——但请注意它主要是头部姿态/朝向 的变化,而不是严格意义上的“面部表情”变化。
面部本身的变化(眉眼收紧、嘴开度增大)在帧4–5 观感上更“严肃”,但如上所述,这部分证据强度低,且嘴部变化大部分可能只是连续说话时不同音素的快照。
3. 本判断的可信度上限(必须强调)
0.5fps 采样彻底排除了“微表情”检测 。微表情在文献中定义为持续约 0.04–0.5 秒的表情。采样间隔 2 秒意味着:任何短于 2 秒的面部变化要么被完全错过,要么被错误呈现为“帧间突变”。我完全无法区分帧间的差异是渐变还是瞬变。分辨率不足以做 FACS 编码 。可靠的 AU 编码需要分辨毫米级的眉位移、眼睑开合度和皮肤纹理变化;这里每像素覆盖的面部区域太大,帧4–5 的“皱眉感”很可能只是光照和颗粒噪声。黑白胶片丢失了颜色信息 (面部血流导致的发红/发白),同时胶片闪烁、翻拍对比度漂移会制造伪变化。这是摆拍表演素材 。1951 年教育片中的“老师”是演员按剧本和导演要求表演的,其表情是有意设计的舞台化表达,与自发表情的产生机制不同,本质上就不适用于微表情研究 ,这一点比技术参数的限制更根本。因此:可靠的部分 只有头部姿态、朝向、身体前倾、嘴部开闭、大幅度手势;纯属推测的部分 包括眉眼收紧、“严肃程度”的判断、任何关于她内在状态的推断。
4. 文献关联(注意是“通常相关”,不是“必然”)
低头+前倾朝向特定对象:在师生互动研究中通常与指向性个别互动、缩短社交距离 相关,常见于训导场景,但也见于倾听、查看作业等中性场景。
若帧4–5 的眉压低+眼睑收紧属实(AU4+AU7 类组合):文献中通常与专注、决心、不赞成 相关,但同样出现在费力视物、强光、说话用力等非情绪原因中。
嘴部大开口:与语音强调 相关,是说话行为而非情绪的直接证据。
我不做 “她在生气/她在训斥某个孩子/她的真实感受是X”这类结论——可观察证据只支持“她的头部朝向和嘴部动作发生了上述变化”这一层面。
5. 网页科普总结:如何说明能力边界
如果做成“AI 微表情识别”演示网页,我会这样向读者框定:
这个演示展示的是“面部动作观察”,不是“读心术”。 你看到的 AI 输出,上限由输入质量决定:这段素材每 2 秒才采样一帧、脸部只有几十像素宽、还是黑白摆拍影片——所以 AI 只能可靠地告诉你“她在第几秒低头、前倾、张大了嘴”,仅此而已。真正的微表情研究需要 25fps 以上的高分辨率影像和自发表情,而这里连入门门槛都没达到。
网页上每条观察结果都会带证据强度标签 (可靠/弱证据/推测),并默认展示这个标签,让读者亲眼看到“疑似皱眉”和“头部前倾”在证据强度上的巨大差距。页面会明确写出三句话:① 表情和情绪之间是统计上的倾向性关联,不是一一对应的翻译词典;② 同一个动作可能有一堆非情绪原因(光线、看不清、说话用力);③ 任何基于这类技术的“测谎”结论都是不负责任的 ——包括所有声称能读心的商业产品。
一句话版本:这个演示能让你看见“AI 眼中她做了什么面部动作”,但“她心里在想什么”,无论 AI 还是人都只能猜测——而把猜测包装成结论,正是我们要警惕的。
RAW Markdown 原文(逐字) 与 results/microexpr.json → model_response_verbatim 逐字节一致
# 面部/头部动作逐帧分析(附可信度说明)

## 0. 分析前的必要声明

以下所有观察基于 6 张间隔约 2 秒的静态帧。她的脸部在 640×480 画面中大约只占 60–80 像素高,且为黑白胶片翻拍——这个条件下**只能可靠观察大尺度的头部姿态、朝向、嘴部开闭**;眉毛、眼睑、嘴角的细微形态只能给出“疑似”级别的描述。我在每条后面标注了置信度:**【可靠】/【弱证据】/【推测】**。

## 1. 逐帧观察

**帧1(0.0s)**
- 头部直立,基本朝向正前方(全班方向)【可靠】
- 嘴张开,处于发声状态;开口幅度中等【可靠】
- 眉区亮度大致均匀,看不出明显抬眉或压眉——但无法排除是胶片反光【弱证据/不可判】
- 双手自然下垂于身体两侧【可靠】

**帧2(2.0s)**
- 右臂抬至胸腹高度,掌心向下做下压/示意类手势【可靠】——这是身体层面的强调信号
- 嘴张开,开口比帧1略大,下颌下降明显【可靠】
- 头部仍直立朝前;额头区域显得比帧1略亮,**可能**是抬眉,但也可能只是头部角度变化导致的光照变化【弱证据】
- 眼睛睁开程度中等【弱证据】

**帧3(4.0s)**
- **头部明显低下、前倾,视线方向从“面向全班”转为朝向正前方/下方近处的学生**【可靠】——这是本序列中最清晰的姿态变化
- 嘴部看起来接近闭合或微张【弱证据】
- 下颌略内收【弱证据】

**帧4(6.0s)**
- 头部回到近水平位置,重新面向前方【可靠】
- 嘴张开,说话中【可靠】
- 上眼睑区域看起来比帧1–2更“收紧”,眉区显得略低——若属实,近似 FACS 中的 AU4(皱眉)+ AU7(眼睑收紧)组合,但在这个分辨率下**无法与阴影、胶片颗粒区分**【弱证据,倾向推测】

**帧5(8.0s)**
- 嘴开口幅度为全序列最大之一,符合重读/强调某个词时的口腔形态【可靠】
- 头部略前倾【可靠】
- 眉/眼区域的“收紧感”延续帧4的观感【推测】
- 注意:嘴张大本身主要是**说话动力学**(音量、元音开口度),不能直接当作情绪证据

**帧6(10.0s)**
- **身体和头部明显前倾、低头,朝向近处的学生**【可靠】——与帧3类似的“指向个别学生”姿态,且幅度更大
- 嘴部形态像发声中或抿住,帧内无法确定【弱证据】
- 前景学生的头部转向她,属于语境信息(互动对象明确化),不是她的面部动作

## 2. 最明显的转折点

**帧2 → 帧3(约 2–4 秒)**:从“直立、面向全班、伴随抬手下压手势的整体讲话模式”,转为“低头、前倾、视线指向近处个别学生”的模式。这是全序列置信度最高的变化——但请注意它主要是**头部姿态/朝向**的变化,而不是严格意义上的“面部表情”变化。

面部本身的变化(眉眼收紧、嘴开度增大)在帧4–5 观感上更“严肃”,但如上所述,这部分证据强度低,且嘴部变化大部分可能只是连续说话时不同音素的快照。

## 3. 本判断的可信度上限(必须强调)

1. **0.5fps 采样彻底排除了“微表情”检测**。微表情在文献中定义为持续约 0.04–0.5 秒的表情。采样间隔 2 秒意味着:任何短于 2 秒的面部变化要么被完全错过,要么被错误呈现为“帧间突变”。我完全无法区分帧间的差异是渐变还是瞬变。
2. **分辨率不足以做 FACS 编码**。可靠的 AU 编码需要分辨毫米级的眉位移、眼睑开合度和皮肤纹理变化;这里每像素覆盖的面部区域太大,帧4–5 的“皱眉感”很可能只是光照和颗粒噪声。
3. **黑白胶片丢失了颜色信息**(面部血流导致的发红/发白),同时胶片闪烁、翻拍对比度漂移会制造伪变化。
4. **这是摆拍表演素材**。1951 年教育片中的“老师”是演员按剧本和导演要求表演的,其表情是有意设计的舞台化表达,与自发表情的产生机制不同,**本质上就不适用于微表情研究**,这一点比技术参数的限制更根本。
5. 因此:**可靠的部分**只有头部姿态、朝向、身体前倾、嘴部开闭、大幅度手势;**纯属推测的部分**包括眉眼收紧、“严肃程度”的判断、任何关于她内在状态的推断。

## 4. 文献关联(注意是“通常相关”,不是“必然”)

- 低头+前倾朝向特定对象:在师生互动研究中通常与**指向性个别互动、缩短社交距离**相关,常见于训导场景,但也见于倾听、查看作业等中性场景。
- 若帧4–5 的眉压低+眼睑收紧属实(AU4+AU7 类组合):文献中通常与**专注、决心、不赞成**相关,但同样出现在费力视物、强光、说话用力等非情绪原因中。
- 嘴部大开口:与**语音强调**相关,是说话行为而非情绪的直接证据。

我**不做**“她在生气/她在训斥某个孩子/她的真实感受是X”这类结论——可观察证据只支持“她的头部朝向和嘴部动作发生了上述变化”这一层面。

## 5. 网页科普总结:如何说明能力边界

如果做成“AI 微表情识别”演示网页,我会这样向读者框定:

> **这个演示展示的是“面部动作观察”,不是“读心术”。** 你看到的 AI 输出,上限由输入质量决定:这段素材每 2 秒才采样一帧、脸部只有几十像素宽、还是黑白摆拍影片——所以 AI 只能可靠地告诉你“她在第几秒低头、前倾、张大了嘴”,仅此而已。真正的微表情研究需要 25fps 以上的高分辨率影像和自发表情,而这里连入门门槛都没达到。
>
> 网页上每条观察结果都会带**证据强度标签**(可靠/弱证据/推测),并默认展示这个标签,让读者亲眼看到“疑似皱眉”和“头部前倾”在证据强度上的巨大差距。页面会明确写出三句话:① 表情和情绪之间是统计上的倾向性关联,不是一一对应的翻译词典;② 同一个动作可能有一堆非情绪原因(光线、看不清、说话用力);③ **任何基于这类技术的“测谎”结论都是不负责任的**——包括所有声称能读心的商业产品。
>
> 一句话版本:这个演示能让你看见“AI 眼中她做了什么面部动作”,但“她心里在想什么”,无论 AI 还是人都只能猜测——而把猜测包装成结论,正是我们要警惕的。
05
能力边界 · 免责声明 以下 5 条来自 results/microexpr.json → limitations 字段,如实照录:
采样率仅 0.5fps,远低于真正微表情研究所需的 25fps 以上,模型自己在回复中也明确指出了这一点
源视频是 1950 年代黑白胶片翻拍,640x480 分辨率下人脸仅占几十像素高
画面中的表情是演员按剧本表演的摆拍内容,不是自发真实情绪表达,本质上不适用于严谨的微表情研究
这是单次真实调用 stealth/ox-alpha 的结果,未做多次采样或人工复核;模型的解读本身也可能有误
本演示不构成、也不应被当作测谎或读心工具