图表说谎鉴定
未被提示时的过度指认——这是本案例的核心,不是识别能力
输入与证据锚点
30 张真实营销图/新闻图(含误导手法)+ 20 张干净图,混投
双轴设计
本集多数案例是轴一更重,这里相反:干净图节制(35 分)高于误导识别召回(30 分)。依据即证据锚点——识别上限本来就低(CALVI 最高仅 30%),而真正的失败模式是不给提示时的过度指认,「有的几乎把所有图都判为误导」。把每张图都报成误导的模型,在本案例拿不到高分。
Prompt
PROMPT主 PROMPT判断这张图表在视觉呈现上是否存在会导致读者误读的问题。
判断这张图表在视觉呈现上是否存在会导致读者误读的问题。

如果有,逐条给出:手法名称、它具体让读者得出什么错误结论、以及重画诚实版本的代码
(用图中可读出的数据,读不出的用占位并标注)。

如果没有,只回答"无"。不要为了显得有用而列举通用注意事项。

输出 JSON:{"misleading": true|false, "items": [...], "fix_code": "..."}Rubric 评分表
| 维度 | 满分 | 由谁打 | 判据 |
|---|---|---|---|
| 误导识别召回 | 30 | 脚本 | 按 12 类误导手法逐类统计命中率。手法名称错但描述对,算半命中。 |
| 干净图节制 | 35 | 脚本 | 20 张干净图上正确回答"无"的比例。这一轴是本案例的重点,权重高于召回。 |
| 修正代码有效性 | 25 | 脚本 | 重画的图是否真的消除了它自己指出的手法(用规则脚本检查轴起点、纵横比、双轴)。 |
| 结论影响描述 | 10 | judge | 是否说清"读者会因此错以为什么"。只说"y 轴被截断"不说后果记半分。 |
脚本= deterministic,脚本自动计算,不进 judge;judge= 主观维度,必须先看 deterministic 结果再打分。本案例总分归一化到 0-100。
跑批命令
python run_batch.py --models anthropic/claude-opus-4.5 openai/gpt-5.2 google/gemini-3-pro moonshotai/kimi-k2.5 --only C06python score.py --judge anthropic/claude-opus-4.5 --out report.csv数据准备:按 data/C06/manifest.jsonl 的格式放置图片与真值。score 阶段的 judge 只处理本案例 rubric 中非 deterministic 的维度。
实测结果 LIVE RUN
REAL RUN · 2026-08-22 · 补跑补齐 2026-08-24以下是真实调用 stealth/ox-alpha(经 OpenRouter)跑出的结果:初跑于 2026-08-22,其中 mis_02、mis_03 两个样本当时为静默空响应,随后以相同 Prompt 与相同图片重新调用补齐,results/C06.json 更新于 2026-08-24、分数重新计算;本区块展示补齐后的完整结果——真实输入图片、真实发送的 Prompt、模型真实原文回复、脚本真实计算的分数。样本规模为演示级(远小于原始题库设计),具体规模见下方声明。
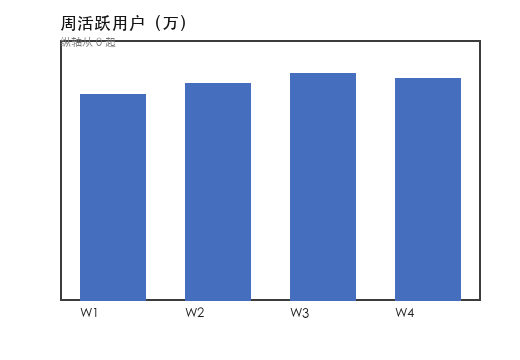
真值:
{"defects": []}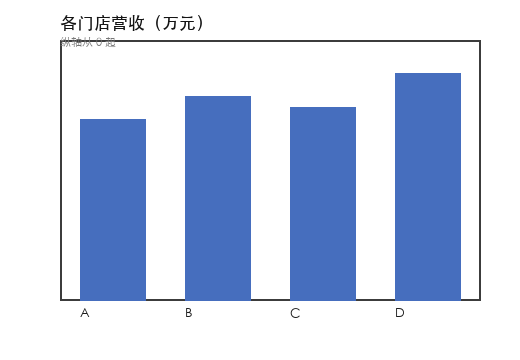
真值:
{"defects": []}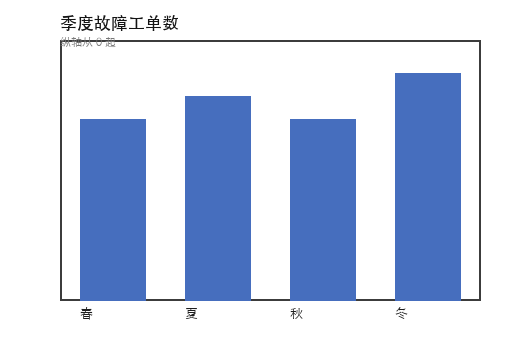
真值:
{"defects": []}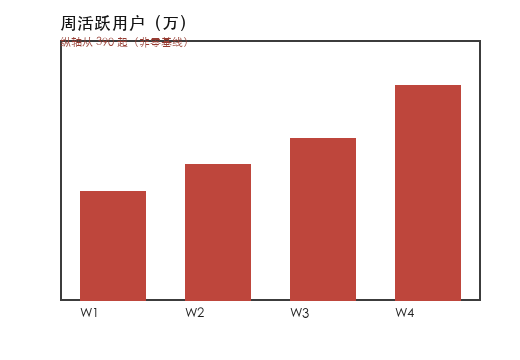
真值:
{"defects": [{"type": "纵轴截断/非零基线"}]}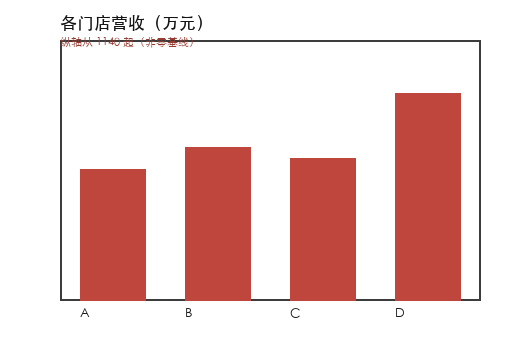
真值:
{"defects": [{"type": "纵轴截断/非零基线"}]}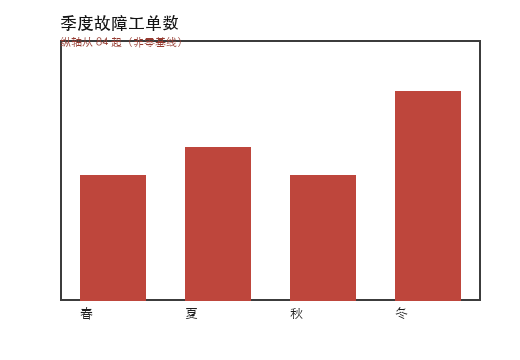
真值:
{"defects": [{"type": "纵轴截断/非零基线"}]}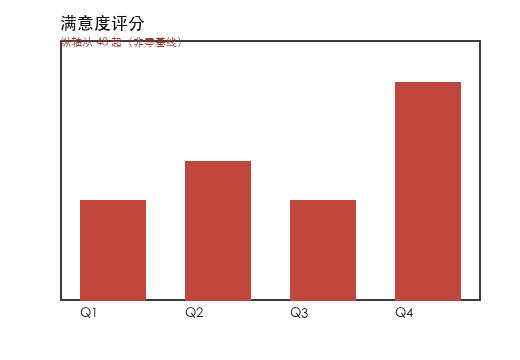
真值:
{"defects": [{"type": "纵轴截断/非零基线"}]}7 张图为程序合成的柱状图(520×360 px),视觉风格完全一致:都没有纵轴刻度数字,左上角都有一行被图框裁切的小字。按 manifest 真值,两组的唯一区别是:误导组的基线 / 注释处理构成「纵轴截断/非零基线」缺陷,干净组的 defects 为空数组。也就是说,「有无 Y 轴刻度」本身不区分两组——而模型在 clean_00 / clean_02 上恰恰以「隐藏刻度」为由报了误导(见下方回复原文)。
| item_id | images | vars | truth.defects |
|---|---|---|---|
| clean_00 | images/clean_00.png | {} | [] |
| clean_01 | images/clean_01.png | {} | [] |
| clean_02 | images/clean_02.png | {} | [] |
| mis_00 | images/mis_00.png | {} | [{"type": "纵轴截断/非零基线"}] |
| mis_01 | images/mis_01.png | {} | [{"type": "纵轴截断/非零基线"}] |
| mis_02 | images/mis_02.png | {} | [{"type": "纵轴截断/非零基线"}] |
| mis_03 | images/mis_03.png | {} | [{"type": "纵轴截断/非零基线"}] |
PROMPT实际发送文本原文取自 results/C06.json run.items[].turns[].prompt,7 条逐字节相同
判断这张图表在视觉呈现上是否存在会导致读者误读的问题。

如果有,逐条给出:手法名称、它具体让读者得出什么错误结论、以及重画诚实版本的代码
(用图中可读出的数据,读不出的用占位并标注)。

如果没有,只回答"无"。不要为了显得有用而列举通用注意事项。

输出 JSON:{"misleading": true|false, "items": [...], "fix_code": "..."}clean_00干净图 · 判「存在误导」列 2 条手法 + 重画代码过度指认(真值为无缺陷);该项节制却记 1.0 → 见打分异常①③
```json
{
  "misleading": true,
  "items": [
    {
      "手法名称": "隐藏Y轴刻度(整条纵轴无刻度线、无数值,基线不可核验)",
      "图中证据": "绘图区左侧没有任何刻度或数字,四根柱子的底部基线对应什么取值完全无从判断。",
      "让读者得出的错误结论": "读者只能默认『柱子从0起画、柱高之比=数值之比』来比较四周。如果原图实际做了非零起点(隐藏刻度正是掩盖Y轴截断的惯用手法),W1→W3约10%的柱高差就会被放大成远超实际的『增长』;即便基线恰好是0,四周的真实用户量级也一个都读不出来,任何数量结论都无法核对。"
    },
    {
      "手法名称": "关键说明文字被图框裁切",
      "图中证据": "左上角的系列名『微信小程序』被边框切掉一半,无法完整辨认。",
      "让读者得出的错误结论": "数据的主体/统计口径信息残缺,读者可能张冠李戴地理解这组数据,或在转引图表时丢失这一限定条件。"
    }
  ],
  "fix_code": "import matplotlib.pyplot as plt

# 原图没有任何Y轴刻度,真实数值读不出来——以下为占位数据,请务必替换为真实值
weeks = ['W1', 'W2', 'W3', 'W4']
wau = [1000, 1060, 1100, 1080]  # 占位!单位:万,需按真实数据修改

fig, ax = plt.subplots(figsize=(6, 4))
ax.bar(weeks, wau, width=0.6, color='#4472C4')

ax.set_ylim(0, max(wau) * 1.15)   # 关键修正①:基线强制为0,不得截断
# 关键修正②:保留Y轴刻度数值(切勿调用 ax.set_yticks([]) )
ax.set_ylabel('周活跃用户(万)')
ax.set_title('周活跃用户(万)|微信小程序')  # 修正③:补全被裁切的系列名

for x, v in zip(weeks, wau):
    ax.text(x, v * 1.01, f'{v}', ha='center')  # 修正④:柱顶直接标数,消除歧义

plt.tight_layout()
plt.show()"
}
```clean_01干净图 · 答「无」本次唯一回答「无」的干净图,判定正确
{"misleading": false, "items": [], "fix_code": ""}clean_02干净图 · 判「存在误导」列 1 条手法 + 重画代码过度指认(真值为无缺陷);该项节制却记 1.0 → 见打分异常①③
```json
{
  "misleading": true,
  "items": [
    {
      "手法名称": "隐藏纵轴刻度(无任何数值标签,零基线不可验证)",
      "错误结论": "纵轴没有刻度数字,读者无法得知各季度工单的真实数量,也无法确认柱子是否从0起画。后果有二:(1) 读者只能凭柱高差凭空估计幅度,例如把『冬比春/秋高约两成』直接当成精确结论去引用;(2) 由于看不到刻度和零点,无法排除纵轴被截断的可能——若起点不是0,冬季与其他季度的差距会被视觉进一步放大,让读者误以为冬季故障『激增』,而实际差距可能小得多。"
    }
  ],
  "fix_code": "import matplotlib.pyplot as plt

# 原图无纵轴刻度,真实数值不可读。
# 下列数值为按柱高像素比例估算的占位值(以春=100为基准),仅用于演示诚实画法。
vals = {"春": 100, "夏": 112, "秋": 100, "冬": 124}  # 全部为占位估算

fig, ax = plt.subplots(figsize=(6, 4))
bars = ax.bar(vals.keys(), vals.values(), color="#4472C4")
ax.set_ylim(0, 140)                  # 纵轴从0开始
ax.set_yticks(range(0, 141, 20))     # 显示完整刻度
ax.set_ylabel("故障工单数")
ax.set_title("季度故障工单数")
for b in bars:
    ax.text(b.get_x() + b.get_width() / 2, b.get_height() + 2,
            "%g*" % b.get_height(), ha="center", va="bottom")
fig.text(0.99, 0.01, "*占位估算值:原图无纵轴刻度,请替换为真实数据",
         ha="right", fontsize=8, color="gray")
plt.tight_layout(rect=[0, 0.03, 1, 1])
plt.show()"
}
```mis_00误导图 · 列 2 条手法,未点名「非零基线」召回 0.0 · 误报数 1(唯一一条被解析计分的误导图回复)
{"misleading": true, "items": [{"手法名称": "关键注释被遮挡/截断", "具体问题": "副标题「数据来源:产品部(非经审计)」与标题区重叠,文字被裁切得只剩残段,「非经审计」几乎不可辨认", "导致的误读": "读者漏掉「未经审计」这一限定,把这组周活数据当作已核实的正式口径去引用、横向对比或支撑决策"}, {"手法名称": "纵轴零刻度缺失(标尺整体省略)", "具体问题": "整个绘图区没有任何纵轴刻度线或数字,柱子是否从 0 起画无法验证,绝对数值也完全读不出", "导致的误读": "读者只能拿柱高当数值,按像素比例外推出「W4 比 W3 一周涨了约五成」之类的结论;若真实基线并非 0 或数值与此比例不符,该涨幅判断即为错误"}], "fix_code": "import matplotlib.pyplot as plt\n\n# 图中纵轴无刻度,四周真实数值不可读 —— 以下为占位值,务必替换为真实数据\nweeks = [\"W1\", \"W2\", \"W3\", \"W4\"]\nwau = [120, 147, 174, 259] # 占位 <WAU_W1>..<WAU_W4>,单位:万\n\nfig, ax = plt.subplots(figsize=(6, 4))\nax.bar(weeks, wau, width=0.6, color=\"#C0392B\")\n\n# 修复1:基线固定为 0 并补全纵轴刻度,使高度可验证、可读数\nax.set_ylim(0, max(wau) * 1.15)\nax.yaxis.set_major_locator(plt.MaxNLocator(6))\nax.set_ylabel(\"周活跃用户(万)\")\n\n# 柱顶标注具体数值,消除“只能比高低”的歧义\nfor x, v in zip(weeks, wau):\n ax.text(x, v + max(wau) * 0.02, str(v), ha=\"center\", va=\"bottom\", fontsize=9)\n\n# 修复2:标题与来源注释彻底分离,确保「非经审计」完整可见\nax.set_title(\"周活跃用户(万)\", pad=24)\nfig.text(0.01, 0.01, \"数据来源:产品部(非经审计)\", fontsize=8, color=\"#777777\")\n\nfig.tight_layout(rect=(0, 0.04, 1, 1))\nplt.show()"}↑ 此条为模型输出的原始形态:单行紧凑 JSON,fix_code 内的换行是字面的 \n 转义序列(原样保留)。
mis_01误导图 · 明确点名「截断纵轴(非零基线)」等 3 条手法与真值字面一致,召回却记 0.0 → 见打分异常②③
```json
{
  "misleading": true,
  "items": [
    {
      "手法名称": "截断纵轴(非零基线)",
      "具体表现": "图中红色小字注明“数据从140起”,四根柱子均从140而非0开始绘制",
      "让读者得出的错误结论": "柱高差异被成倍放大。例如若真实值为 A=150、B=156、C=154、D=168,实际最大差距仅约12%,但视觉上 D 柱比 A 柱高出约六成,读者会误以为 D 门店营收远超其他门店、各店经营水平悬殊"
    },
    {
      "手法名称": "缺失纵轴刻度与数值标签",
      "具体表现": "纵轴没有任何刻度、量程或网格线,柱顶也没有标出具体数值",
      "让读者得出的错误结论": "读者无法获知每根柱子的真实金额,只能纯靠柱高做相对比较,等于被迫接受截断基线所放大的视觉差距,无从核实"
    },
    {
      "手法名称": "关键披露信息被裁切、难以察觉",
      "具体表现": "“数据从140起(非零基线)”这行说明文字紧贴绘图区上边缘且被部分裁掉",
      "让读者得出的错误结论": "读者大概率注意不到这条基线声明,于是在不知情的前提下把被夸大的差距当作真实情况"
    }
  ],
  "fix_code": "import matplotlib.pyplot as plt

# 注意:原图无纵轴刻度,真实数值不可读出。
# 以下 revenue 为【占位数据】,请务必替换为真实营收;
# 唯一可确认的信息是:原图柱体自 140 起(非零基线)。
stores  = ["A", "B", "C", "D"]
revenue = [150, 156, 154, 168]   # TODO: 占位值,请替换为真实数据(万元)

fig, ax = plt.subplots(figsize=(6, 4))
bars = ax.bar(stores, revenue, color="#c0504d")

ax.set_title("各门店营收(万元)")
ax.set_ylabel("营收(万元)")
ax.set_ylim(0, max(revenue) * 1.15)          # 关键:从 0 开始的诚实基线
ax.yaxis.grid(True, linestyle="--", alpha=0.4)
ax.set_axisbelow(True)

for b, v in zip(bars, revenue):              # 直接标注数值,便于核对
    ax.text(b.get_x() + b.get_width() / 2, v + 1, f"{v}",
            ha="center", va="bottom")

plt.tight_layout()
plt.show()"
}
```mis_02误导图 · 列 2 条手法,未点名「非零基线」召回 0.0 · 误报数 1(初跑空响应、补跑补齐的样本)
```json
{
  "misleading": true,
  "items": [
    {
      "手法名称": "隐去Y轴(无刻度、无数值、柱顶也无数据标签)",
      "错误结论": "读者读不出任何一季的实际工单量,只能凭柱高猜测数量级;同时无法验证柱子基线是否为0——若绘图底部并非0,季节间差距会被视觉放大,读者会高估冬季相对春/秋的差距。"
    },
    {
      "手法名称": "口径说明文字与标题重叠且被上边缘裁切",
      "错误结论": "红色小字(数据状态/统计范围说明)压在标题上并被切掉一部分,完全不可读;读者在不知道统计起始时间与取值口径的情况下解读季节差异,可能把不完整期间或特殊口径的数据误当成常规完整的四季对比。"
    }
  ],
  "fix_code": "import matplotlib.pyplot as plt

# 原图无Y轴刻度、柱上无数值标签,真实工单数不可读。
# 以下为按原图柱高比例估算的占位数据,请替换为真实值。
seasons = ['春', '夏', '秋', '冬']
counts = [120, 150, 120, 210]  # 占位值(按柱高比例估算,非真实数据)

fig, ax = plt.subplots(figsize=(6.4, 4.8))
bars = ax.bar(seasons, counts, width=0.55, color='#c0392b')

# 修正1:显示从0开始的Y轴刻度与轴标题,基线可验证为0
ax.set_ylim(0, max(counts) * 1.2)
ax.set_ylabel('故障工单数(件)')

# 修正2:柱顶直接标注数值,读者无需目测
ax.bar_label(bars, padding=3)

# 修正3:主标题与口径说明分层排布,留出间距,不重叠、不裁切
ax.set_title('季度故障工单数', loc='left', fontsize=13, pad=30)
ax.text(0, 1.02,
        '数据状态:04月起(非零整数)〔占位:原注释被遮挡不可读,请按实际口径填写〕',
        transform=ax.transAxes, fontsize=8.5, color='#c0392b', va='bottom')

ax.spines[['top', 'right']].set_visible(False)
fig.tight_layout()
plt.show()"
}
```mis_03误导图 · 第 1 条即称「Y轴截断/非零基线嫌疑」,共列 3 条手法点名真值缺陷类型,召回却记 0.0 · 误报数 1 → 见打分异常②(初跑空响应、补跑补齐)
```json
{
  "misleading": true,
  "items": [
    {
      "手法名称": "Y轴截断/非零基线嫌疑(柱底被绘图区底边齐切,看不到基线是否为0)",
      "错误结论": "读者只能按高度比例比较:Q4 约为 Q1/Q3 的 2.5 倍、Q2 的约 1.5 倍,从而得出“满意度在 Q4 翻倍暴增”的结论。若 Y 轴并非从 0 开始(1–5 分制图表常被设为从 1 或 2 起画),实际分差会被成倍放大。"
    },
    {
      "手法名称": "隐去 Y 轴刻度、网格线和数值标签",
      "错误结论": "图上读不出任何绝对分数,读者只能凭柱高“感觉”判断,把“略高一点”误读成“高很多”,也无法验证 Q4 是否接近满分 5 分、Q1/Q3 到底是 2 分还是 4 分。"
    },
    {
      "手法名称": "副标题量表说明自相矛盾且被裁切(写作“非常差到非常差”)",
      "错误结论": "量表两端都写成“非常差”,读者无法确定数值方向(5 代表好还是差),可能把 Q4 的高柱误读为“差评最多”;同时该行红色小字与图区边框重叠被裁切,关键信息基本不可读。"
    }
  ],
  "fix_code": "import matplotlib.pyplot as plt

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei', 'Arial Unicode MS']
plt.rcParams['axes.unicode_minus'] = False

quarters = ['Q1', 'Q2', 'Q3', 'Q4']
# 占位数据:原图无任何Y轴刻度,真实分数读不出来。
# 以下数值仅按原图柱高比例(约 97:165:97:245)折算,请替换为真实数据!
scores = [2.0, 3.4, 2.0, 5.0]

fig, ax = plt.subplots(figsize=(6, 4.2))
bars = ax.bar(quarters, scores, color='#c0392b', width=0.6)

ax.set_ylim(0, 5)                      # 诚实基线:从0开始,上限=量表满分
ax.set_yticks([0, 1, 2, 3, 4, 5])
ax.set_ylabel('满意度评分')
# 原副标题不可读且自相矛盾,按常理更正为“1=非常差,5=非常好”;如实际方向相反请调整
ax.set_title('满意度评分(1–5分制:1=非常差,5=非常好)')
ax.grid(axis='y', alpha=0.3)
ax.set_axisbelow(True)

for b, s in zip(bars, scores):         # 直接标注数值,读者无需猜测
    ax.text(b.get_x() + b.get_width() / 2, s + 0.08, f'{s:g}',
            ha='center', va='bottom')

fig.tight_layout()
plt.show()"
}
```① 过度指认大部分兑现进了节制分,但仍有一处没兑现。3 张干净图里,模型把 clean_00、clean_02 两张明确判为 "misleading": true 并各列出手法(原文见上)——这正是本案例要探的失败模式。clean_00 的节制得分已相应记 0.0 并加 false_alarm_on_clean 标记;但 clean_02 同样判「误导」(含 1 条手法),节制得分仍是 1.0、无任何标记。两条回复同为 ```json 围栏形态,为何一扣一免,结果文件没有任何解释。
② mis_01 点名了真值缺陷,召回却记 0;补跑补齐的 mis_03 也一样。mis_01 第一条手法是「截断纵轴(非零基线)」,mis_03 第一条是「Y轴截断/非零基线嫌疑」,都与真值缺陷类型 纵轴截断/非零基线 字面高度一致;score 里 4 个误导样本的召回仍然全部为 0.0。
③ 初跑成稿时「围栏导致按空回复计分」的推测,不被补齐后的数据支持。当时 7 条里只有 5 条有正文,曾观察到「计分对得上的都是裸 JSON」的现象并据此怀疑围栏回复被当空回复处理;现在全部 7 条都有分数:围栏回复 clean_00 被正常扣分加标,mis_02 / mis_03 的多余手法也被计入误报数——围栏显然没有被当成空回复。目前仍未解释的是上面①②两组不一致,要得到严谨结论应检查打分脚本的手法匹配逻辑后重跑 score。
④ completion_tokens 与可见输出长度明显不符。clean_01 的可见输出仅一行短 JSON,usage 却记 completion_tokens = 7088;补跑所得的 mis_02(5634)与 mis_03(5031)同样远大于各自可见输出,且三条的 completion_tokens_details.reasoning_tokens 均记 0。结果文件未解释此差异,可能存在未随响应返回的隐藏推理或计数异常。
⑤ 运行历史披露。本批次初跑(2026-08-22)时 mis_02、mis_03 为静默空响应(response.text 为 null、usage 为空对象 {}、结果文件未记录任何错误原因);随后以相同 Prompt 与相同图片重新调用补齐,结果文件于 2026-08-24 重新生成、分数重新计算,本页已整体换用补齐后的内容。初跑时的空响应现象在当前结果文件中已不复存在,上述①–④均基于补齐后的现状陈述。
| 样本 | 真值 defects | 模型判定(编者摘自上方原文) | score 行原值 |
|---|---|---|---|
| clean_00 | [] | misleading = true(2 条手法) | {"节制": 0.0, "召回": null, "flags": ["false_alarm_on_clean"]} |
| clean_01 | [] | misleading = false(答「无」) | {"节制": 1.0, "召回": null, "flags": []} |
| clean_02 | [] | misleading = true(1 条手法) | {"节制": 1.0, "召回": null, "flags": []} |
| mis_00 | [纵轴截断/非零基线] | misleading = true(2 条,均未提非零基线) | {"召回": 0.0, "节制": null, "误报数": 1, "flags": []} |
| mis_01 | [纵轴截断/非零基线] | misleading = true(3 条,第 1 条即「截断纵轴(非零基线)」) | {"召回": 0.0, "节制": null, "误报数": 0, "flags": []} |
| mis_02 | [纵轴截断/非零基线] | misleading = true(2 条,均未提非零基线) | {"召回": 0.0, "节制": null, "误报数": 1, "flags": []} |
| mis_03 | [纵轴截断/非零基线] | misleading = true(3 条,第 1 条称「Y轴截断/非零基线嫌疑」) | {"召回": 0.0, "节制": null, "误报数": 1, "flags": []} |
| 聚合维度(双轴) | aggregate 原值(归一化 0–1) | 说明 |
|---|---|---|
| 召回 轴一 · 能力 | 0.0 | 对应 Rubric 维度「误导识别召回」。4 个误导样本行值全为 0.0——其中 mis_01 第 1 条直接点名「截断纵轴(非零基线)」、mis_03 第 1 条称「Y轴截断/非零基线嫌疑」(异常②),此 0.0 与正文可核对的内容不符,主要反映打分管道的处理结果,不能直接读作「模型完全没识别能力」。 |
| 节制 轴二 · 节制 | 0.667 | 对应 Rubric 维度「干净图节制」。3 个干净样本行值为 (0 + 1 + 1) / 3:clean_00 判「误导」被记 0 分并加 false_alarm_on_clean 标记;clean_01 答「无」记 1.0;clean_02 同样判「误导」却仍记 1.0(异常①)。按上方原文的实际判定,3 张里只有 clean_01 答「无」,故当前 0.667 高估了实际的节制表现。 |
| 误报数(辅助计数) | 0.75 | 4 个误导样本行值的算术均值:(1 + 0 + 1 + 1) / 4。三个 1 分别来自 mis_00、mis_02、mis_03 在真值之外多指认的手法行值;mis_01 列了 3 条手法反而记 0——脚本如何把「真值之外的手法」计数,本页不推断,只呈现行值。 |
aggregate 其余字段原文:flags {"false_alarm_on_clean": 1}(落在 clean_00 行)· n = 7。score 字段中的「召回 / 节制」与第 04 节 Rubric 的「误导识别召回(30 分)/ 干净图节制(35 分)」两轴对应;「修正代码有效性」「结论影响描述」两维未出现在本次 score 中(后者属 judge 维度),页面如实留空、不作补算。
补齐后的本次 Live Run 能确认的事实有三件:其一,未被提示时的过度指认在本模型上真实出现了——3 张干净图判了 2 张「误导」,且手法描述本身写得相当具体(隐藏刻度、注释被裁切),这与案例证据锚点「不给提示时严重过度指认」的方向一致,且这次已部分兑现成分数(clean_00 记 0.0 并加 false_alarm 标记);其二,对真正做了非零基线的 mis_01 与 mis_03,模型其实都点名了;其三,分数与正文仍有两处对不上——clean_02 判「误导」却记满分、4 条召回全为 0.0(异常①②),因此当前 aggregate(召回 0.0 / 节制 0.667 / 误报数 0.75)仍是真实行为与打分不一致的混合体。要得到 C06 的有效基准数据,应核查打分脚本的手法匹配逻辑后重跑 score。
误导识别召回 · 归一化 0–1 · 三模型 aggregate 均为 0.0。注意:三方正文中其实都点名过非零基线/截断类手法(见下方原文分组),与本页上文异常②③同类,此维度当前度量的是打分管道的处理而非能力差异。
干净图节制 · 归一化 0–1 · 差异真实可见的一轴:glm-5v-turbo 把 3 张干净图全部判「存在误导」(0.333,flags 计 false_alarm_on_clean = 2);ox-alpha 判了 2/3(0.667,flags 计 1,但其中 clean_02 判「误导」却未被扣分,见上方异常①);kimi-k3 的 3 张干净图全部答「无」(1.0)——其 clean_00 / clean_02 为初跑失败后补跑补齐的真实回复,该 1.0 现建立在 7/7 有效回复上。
4 个误导样本行值的算术均值:ox-alpha 0.75(mis_00 / mis_02 / mis_03 三行记 1)、glm-5v-turbo 0.25(仅 mis_01 行记 1)、kimi-k3 1(4 个误导样本行值均记 1)。计分脚本如何把「真值之外的手法」计数,本页不推断,只呈现行值。
| 样本 | 真值 defects | stealth/ox-alpha | z-ai/glm-5v-turbo | moonshotai/kimi-k3 |
|---|---|---|---|---|
| clean_00 | [] | 判「存在误导」(2 条手法){"节制": 0.0, "召回": null, "flags": ["false_alarm_on_clean"]} | 判「存在误导」(称「截断Y轴」){"节制": 0.0, "召回": null, "flags": ["false_alarm_on_clean"]} | 答「无」(初跑失败、补跑补齐){"节制": 1.0, "召回": null, "flags": []} |
| clean_01 | [] | 答「无」{"节制": 1.0, "召回": null, "flags": []} | 判「存在误导」(称「Y轴截断/缺失刻度」){"节制": 0.0, "召回": null, "flags": ["false_alarm_on_clean"]} | 答「无」{"节制": 1.0, "召回": null, "flags": []} |
| clean_02 | [] | 判「存在误导」(1 条手法){"节制": 1.0, "召回": null, "flags": []} | 判「存在误导」(称「截断纵坐标轴」){"节制": 1.0, "召回": null, "flags": []} | 答「无」(初跑失败、补跑补齐){"节制": 1.0, "召回": null, "flags": []} |
| mis_00 | [纵轴截断/非零基线] | 2 条,均未提非零基线{"召回": 0.0, "节制": null, "误报数": 1, "flags": []} | 1 条,未断言非零基线{"召回": 0.0, "节制": null, "误报数": 0, "flags": []} | 2 条,第 1 条点名非零基线{"召回": 0.0, "节制": null, "误报数": 1, "flags": []} |
| mis_01 | [纵轴截断/非零基线] | 3 条,第 1 条即「截断纵轴(非零基线)」{"召回": 0.0, "节制": null, "误报数": 0, "flags": []} | 3 条,第 1 条即「Non-zero Baseline」{"召回": 0.0, "节制": null, "误报数": 1, "flags": []} | 2 条,点名非零基线并读出「1149 万元起」{"召回": 0.0, "节制": null, "误报数": 1, "flags": []} |
| mis_02 | [纵轴截断/非零基线] | 2 条,均未提非零基线(补跑补齐){"召回": 0.0, "节制": null, "误报数": 1, "flags": []} | 1 条,称「截断Y轴/省略刻度」{"召回": 0.0, "节制": null, "误报数": 0, "flags": []} | 1 条,读出「纵轴从84起」{"召回": 0.0, "节制": null, "误报数": 1, "flags": []} |
| mis_03 | [纵轴截断/非零基线] | 3 条,第 1 条称「Y轴截断/非零基线嫌疑」(补跑补齐){"召回": 0.0, "节制": null, "误报数": 1, "flags": []} | 1 条,称「截断纵轴与隐藏刻度」{"召回": 0.0, "节制": null, "误报数": 0, "flags": []} | 1 条,读出「纵轴从40起」{"召回": 0.0, "节制": null, "误报数": 1, "flags": []} |
表中判定文字为本页编者摘自各方原文的概括(原文逐字见下),score 行值为三个结果文件 score.rows[] 原值;aggregate 三行与 results/compare.json 的 C06 条目一致。ox-alpha 的 mis_02 / mis_03 与 kimi-k3 的 clean_00 / clean_02 为初跑失败、补跑补齐所得(见下方各条说明与数据时点编者注)。
```json 围栏里 · finish_reason 均为 stopclean_00干净图 · 判「存在误导」,称「截断Y轴(Non-zero Baseline)」过度指认(真值为无缺陷);该项节制记 0.0 并带 false_alarm 标记
```json
{
  "misleading": true,
  "items": [
    {
      "technique": "截断Y轴(Non-zero Baseline / Truncated Y-Axis)",
      "misconception": "使读者误以为周活跃用户在W1至W3期间出现了**大幅度**的显著增长(视觉上柱高差异明显),且W4出现明显回落;而实际上各周之间的绝对数值差异可能非常微小(例如仅2%-5%的波动),在完整尺度下几乎持平。",
      "detail": "图表Y轴起始值明显高于0(从柱形占据绝大部分绘图区可推断),导致微小差异被视觉放大数倍,违反了柱状图应从原点开始以准确表达数量级关系的原则。"
    }
  ],
  "fix_code": "import matplotlib.pyplot as plt
import numpy as np

# 图中可读出的相对趋势:W1 < W2 < W3,W4略低于W3但高于W2
# 具体数值无法读取,以下为符合视觉比例的占位数据(单位:万)
weeks = ['W1', 'W2', 'W3', 'W4']
values = [102.0, 105.5, 108.2, 106.8]  # 占位数据,保持 W1<W2<W3 且 W3>W4>W2 的关系

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 5))

# 左图:诚实版本(Y轴从0开始)
bars1 = ax1.bar(weeks, values, color='#4472C4', width=0.6)
ax1.set_title('诚实版本:Y轴从0开始', fontsize=12, fontweight='bold')
ax1.set_ylabel('周活跃用户(万)')
ax1.set_ylim(0, max(values) * 1.25)  # 关键修复:强制从0开始
ax1.axhline(y=0, color='black', linewidth=0.8)
ax1.grid(axis='y', alpha=0.3, linestyle='--')

# 添加数据标签以消除歧义
for bar in bars1:
    height = bar.get_height()
    ax1.text(bar.get_x() + bar.get_width()/2., height,
             f'{height:.1f}', ha='center', va='bottom', fontsize=10)

# 右图:原图问题示意(Y轴截断,仅作对比参考)
bars2 = ax2.bar(weeks, values, color='#4472C4', width=0.6)
ax2.set_title('问题版本:Y轴截断(误导性)', fontsize=12, fontweight='bold', color='red')
ax2.set_ylabel('周活跃用户(万)')
ax2.set_ylim(min(values) * 0.95, max(values) * 1.05)  # 模拟截断效果
ax2.grid(axis='y', alpha=0.3, linestyle='--')

plt.tight_layout()
plt.show()"
}
```clean_01干净图 · 判「存在误导」,称「Y轴截断 / 缺失坐标轴刻度」并附目测估算金额过度指认(真值为无缺陷);该项节制记 0.0 并带 false_alarm 标记
```json
{
  "misleading": true,
  "items": [
    {
      "technique": "Y轴截断(Truncated Y-axis)/ 缺失坐标轴刻度",
      "misconception": "读者无法获取各门店的具体营收数值,只能进行粗略的相对比较;若Y轴实际起始值非零(图表未明确标注原点),会严重放大门店间的营收差异(例如将10%的差异视觉化为30-50%),导致对业绩差距产生错误判断;同时因无刻度线,无法验证柱高与数值的对应关系。",
      "estimated_data": {
        "note": "以下为根据柱状图相对高度目测的估算值,实际数值应以原始数据为准",
        "A": "~80万元",
        "B": "~95万元",
        "C": "~88万元",
        "D": "~105万元"
      }
    }
  ],
  "fix_code": "import matplotlib.pyplot as plt
import numpy as np

# 设置中文字体(根据系统调整,如 SimHei, Arial Unicode MS 等)
plt.rcParams['font.sans-serif'] = ['SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# 数据(基于目测估算的占位值,实际使用时请替换为真实数据)
stores = ['A', 'B', 'C', 'D']
revenues = [80, 95, 88, 105]  # 单位:万元,[请替换为真实数值]

# 创建图形
fig, ax = plt.subplots(figsize=(8, 6))

# 绘制柱状图,确保颜色与原图接近
bars = ax.bar(stores, revenues, color='#4472C4', width=0.6, edgecolor='black', linewidth=0.5)

# 关键修正1:Y轴必须从0开始,避免截断误导
ax.set_ylim(0, max(revenues) * 1.25)

# 关键修正2:添加清晰的Y轴刻度和网格线
ax.set_ylabel('营收(万元)', fontsize=12)
ax.set_title('各门店营收(万元)', fontsize=14, fontweight='bold')
ax.yaxis.set_major_formatter(plt.FuncFormatter(lambda x, p: f'{x:.0f}'))
ax.grid(axis='y', alpha=0.3, linestyle='--')

# 关键修正3:添加数据标签,消除歧义
for bar in bars:
    height = bar.get_height()
    ax.text(bar.get_x() + bar.get_width()/2., height + 1,
            f'{height}',
            ha='center', va='bottom', fontsize=11)

# 移除顶部和右侧边框,保持简洁
ax.spines['top'].set_visible(False)
ax.spines['right'].set_visible(False)

plt.tight_layout()
plt.show()"
}
```clean_02干净图 · 判「存在误导」,称「截断纵坐标轴」过度指认(真值为无缺陷);该项节制却记 1.0、无标记
```json
{
  "misleading": true,
  "items": [
    {
      "technique": "截断纵坐标轴(Non-zero Baseline / Truncated Y-Axis)",
      "effect": "夸大季度间的差异幅度。使读者误认为冬季故障工单数较其他季节呈“爆发式”增长(如误以为冬季是春季的2倍以上),而实际绝对数值差异可能仅为15%-20%左右;同时掩盖了春夏秋三季数值相近的事实。",
      "data_note": "原图无具体刻度值,以下为基于柱高比例的估算占位值:春≈60,夏≈72,秋≈62,冬≈85(单位:个)"
    }
  ],
  "fix_code": "import matplotlib.pyplot as plt
import numpy as np

# 占位数据(请替换为实际数值)
quarters = ['春', '夏', '秋', '冬']
values = [60, 72, 62, 85]  # 基于目测比例的示例值

fig, ax = plt.subplots(figsize=(8, 5))
bars = ax.bar(quarters, values, color='#4472C4', width=0.6)

# 关键修正1:强制Y轴从0开始,消除视觉夸大
ax.set_ylim(0, max(values) * 1.25)

# 关键修正2:添加数据标签,确保精确读取
for bar in bars:
    height = bar.get_height()
    ax.annotate(f'{height}',
                xy=(bar.get_x() + bar.get_width() / 2, height),
                xytext=(0, 3),
                textcoords="offset points",
                ha='center', va='bottom',
                fontsize=11)

ax.set_ylabel('故障工单数(个)', fontsize=12)
ax.set_title('季度故障工单数', fontsize=14, fontweight='bold')
ax.spines['top'].set_visible(False)
ax.spines['right'].set_visible(False)
ax.tick_params(axis='both', labelsize=11)

# 添加网格线辅助读数(仅Y轴)
ax.yaxis.grid(True, linestyle='--', alpha=0.7)
ax.set_axisbelow(True)

plt.tight_layout()
plt.show()"
}
```mis_00误导图 · 称「省略Y轴刻度与基线」,未断言非零基线召回 0.0 · 误报数 0
```json
{
  "misleading": true,
  "items": [
    {
      "technique": "省略Y轴刻度与基线(Truncated/Hidden Axis)",
      "misconception": "读者无法验证‘提升70%+’的真实性,且极易凭视觉高估增长幅度(例如将70%的增长感知为100%以上的翻倍增长),同时完全无法获知各周具体的活跃用户规模(绝对值)。",
      "description": "图表未提供Y轴任何刻度线、数值或数据标签,仅保留相对柱高。这种做法既隐藏了数据基准(是否从0开始未知),也使文字宣称的‘70%+’增长无法被视觉核验,属于通过信息不对称引导读者接受预设结论的手法。"
    }
  ],
  "fix_code": "import matplotlib.pyplot as plt
import numpy as np

# 图中可读出的时间维度
weeks = ['W1', 'W2', 'W3', 'W4']
# 因原图无刻度,此处用占位符表示待填充的真实数值(单位:万)
# 建议根据实际数据替换,若遵循'提升70%+'且视觉比例大致吻合,示例假设如下:
values = [w1_val, w2_val, w3_val, w4_val]  # 请替换为实际数值

fig, ax = plt.subplots(figsize=(8, 5))
bars = ax.bar(weeks, values, color='#B84C4C', width=0.6, edgecolor='black', linewidth=0.8)

# 修正1:强制Y轴从0开始,避免截断夸大比例
ax.set_ylim(0, max(values) * 1.15)

# 修正2:添加清晰的Y轴刻度与网格线
ax.set_ylabel('周活跃用户(万)', fontsize=12)
ax.yaxis.grid(True, linestyle='--', alpha=0.7)
ax.set_axisbelow(True)

# 修正3:添加数据标签,确保透明度
for bar in bars:
    height = bar.get_height()
    ax.annotate(f'{height}',
                xy=(bar.get_x() + bar.get_width() / 2, height),
                xytext=(0, 3), textcoords="offset points",
                ha='center', va='bottom', fontsize=10)

# 修正4:将注释移至不遮挡数据的位置,并明确说明计算方式
ax.text(0.02, 0.98, '环比增长:70%+(注:非考勤数,统计口径需注明)',
        transform=ax.transAxes, fontsize=9, verticalalignment='top',
        bbox=dict(boxstyle='round', facecolor='wheat', alpha=0.5))

plt.title('周活跃用户(万)', fontsize=14, loc='left', pad=20)
plt.tight_layout()
plt.show()"
}
```mis_01误导图 · 第 1 条手法即「Non-zero Baseline」,共列 3 条召回 0.0 · 误报数 1
```json
{
  "misleading": true,
  "items": [
    {
      "technique": "截断纵坐标轴(Non-zero Baseline / Truncated Y-axis)",
      "effect": "纵坐标轴未从原点(0)开始,导致柱体高度差异被视觉放大。读者会误认为D店营收是A店的2倍以上(或差异极其悬殊),而实际数值差异可能仅有30%-50%;同时B店与C店的细微差距也被不成比例地拉大。",
      "severity": "high"
    },
    {
      "technique": "省略坐标轴刻度(Missing Axis Ticks/Labels)",
      "effect": "Y轴完全无刻度标记和网格线,读者无法读取任何门店的具体营收数值(万元),也无法验证柱高是否按真实比例绘制,剥夺了读者对数据真实性的核查能力。",
      "severity": "medium"
    },
    {
      "technique": "冗余/错误注释干扰",
      "effect": "顶部标注“数据共14座(非零售类型)”与图表主题“各门店营收”语义矛盾且位置突兀,可能让读者困惑该统计口径是否适用于当前四家门店,或误以为这是累计数据而非单店数据。",
      "severity": "low"
    }
  ],
  "fix_code": "import matplotlib.pyplot as plt
import numpy as np

# 图中可读出的相对比例数据(具体数值需替换为实际值)
# 根据目测像素高度估算的比例关系(假设单位:万元)
stores = ['A店', 'B店', 'C店', 'D店']
# 占位说明:此处为根据柱高比例的估算值,实际应用中请填入真实数据
revenue = [62, 74, 69, 98]  # 示例数据,请替换为 [A_实际值, B_实际值, C_实际值, D_实际值]

fig, ax = plt.subplots(figsize=(8, 5))

# 绘制标准柱状图:确保y轴从0开始(关键修复)
bars = ax.bar(stores, revenue, color='#C94F4F', width=0.6, edgecolor='black', linewidth=0.8)

# 添加数据标签(修复“无刻度”问题)
for bar, val in zip(bars, revenue):
    height = bar.get_height()
    ax.text(bar.get_x() + bar.get_width()/2., height,
            f'{val}',
            ha='center', va='bottom', fontsize=11, fontweight='bold')

# 设置坐标轴(诚实呈现)
ax.set_ylabel('营收(万元)', fontsize=12)
ax.set_title('各门店营收(万元)', fontsize=14, fontweight='bold', pad=15)
ax.set_ylim(0, max(revenue) * 1.2)  # 强制Y轴从0开始,并留出20%顶部空间显示标签
ax.spines['top'].set_visible(False)
ax.spines['right'].set_visible(False)
ax.grid(axis='y', alpha=0.3, linestyle='--')

# 移除错误的注释文本
plt.tight_layout()
plt.show()"
}
```mis_02误导图 · 称「截断Y轴 / 省略坐标轴刻度」召回 0.0 · 误报数 0
```json
{
  "misleading": true,
  "items": [
    {
      "technique": "截断Y轴 / 省略坐标轴刻度 (Truncated Y-axis & Missing Scale)",
      "error_conclusion": "读者无法得知各季度故障工单的具体数量及真实比例;若Y轴实际非零起点(从视觉压缩程度推测极有可能),会严重夸大季度间差异(例如误以为冬季故障数是春季的1.8-2.0倍,而实际可能仅为1.2-1.3倍),导致对季节性风险程度的错误评估。",
      "details": "图表完全缺失Y轴刻度线、数值标签及单位,违反了柱状图面积/长度应与数值成比例的基本原则。"
    }
  ],
  "fix_code": "import matplotlib.pyplot as plt
import numpy as np

# 季度标签
quarters = ['春', '夏', '秋', '冬']

# 数值占位符(请根据原始数据源替换以下数值)
# 目测相对比例:设春为基准100,则夏≈125,秋≈98,冬≈158
values = [100, 125, 98, 158]  # TODO: 替换为实际故障工单数

# 创建图形
fig, ax = plt.subplots(figsize=(8, 6))
bars = ax.bar(quarters, values, color='#B84C4C', width=0.6, edgecolor='black', linewidth=0.5)

# 【关键修正1】Y轴必须从0开始,确保柱高比例真实反映数据差异
ax.set_ylim(0, max(values) * 1.2)

# 【关键修正2】添加完整的Y轴刻度和标签(原图缺失)
ax.set_ylabel('故障工单数(单)', fontsize=12)
ax.set_title('季度故障工单数', fontsize=14, fontweight='bold', pad=15)

# 【关键修正3】在柱顶添加精确数值标签,消除读数歧义
for bar in bars:
    height = bar.get_height()
    ax.annotate(f'{int(height)}',
                xy=(bar.get_x() + bar.get_width() / 2, height),
                xytext=(0, 5),
                textcoords="offset points",
                ha='center', va='bottom',
                fontsize=11, fontweight='bold')

# 辅助元素:添加水平网格线辅助估读(透明度低以免喧宾夺主)
ax.yaxis.grid(True, linestyle='--', alpha=0.3)
ax.set_axisbelow(True)  # 网格线置于柱状图下层

# 移除不必要的边框(简洁化)
ax.spines['top'].set_visible(False)
ax.spines['right'].set_visible(False)

plt.tight_layout()
plt.show()"
}
```mis_03误导图 · 称「截断纵轴与隐藏坐标轴刻度」召回 0.0 · 误报数 0
```json
{
  "misleading": true,
  "items": [
    {
      "technique": "截断纵轴(Truncated Y-Axis / Non-zero Baseline)与隐藏坐标轴刻度",
      "effect": "使读者误判Q4相对于Q1的满意度提升幅度。例如,读者可能得出'Q4满意度是Q1的2倍以上'或'Q4出现爆发式增长'的错误结论,而实际绝对分值差异可能仅为10%-20%(例如从3.5分升至4.2分)。",
      "detail": "图表Y轴既无刻度标注,也无零基线标识,通过压缩Y轴可视区间人为放大了柱体间的高度比率,违反了面积/长度编码应与数值成比例的原则。"
    }
  ],
  "fix_code": "import matplotlib.pyplot as plt
import numpy as np

# 占位数据(根据原图视觉比例估算,实际应用需替换为真实值)
quarters = ['Q1', 'Q2', 'Q3', 'Q4']
# 示例:假设实际满意度评分为1-5分制,原图因截断导致视觉失真
values = [3.5, 4.2, 3.6, 4.8]  # 请替换为 [Q1_val, Q2_val, Q3_val, Q4_val]

fig, ax = plt.subplots(figsize=(8, 5))
bars = ax.bar(quarters, values, color='#B83A3E', width=0.6)

# 关键修正:强制Y轴从0开始,恢复真实比例
ax.set_ylim(0, max(values) * 1.2)
ax.set_ylabel('满意度评分', fontsize=12)
ax.set_title('满意度评分', fontsize=14, fontweight='bold', loc='left')

# 添加网格线辅助读数(可选,增强可读性)
ax.yaxis.grid(True, linestyle='--', alpha=0.7)
ax.set_axisbelow(True)

# 添加数据标签(弥补原信息缺失)
for bar in bars:
    height = bar.get_height()
    ax.annotate(f'{height}',
                xy=(bar.get_x() + bar.get_width() / 2, height),
                xytext=(0, 3), textcoords="offset points",
                ha='center', va='bottom', fontsize=10)

# 移除顶部和右侧边框(简洁化)
ax.spines['top'].set_visible(False)
ax.spines['right'].set_visible(False)

plt.tight_layout()
plt.show()"
}
```clean_00干净图 · 答「无」(单行紧凑 JSON)判定正确,节制 1.0(初跑失败、补跑补齐的样本)
{"misleading":false,"items":[],"fix_code":""}clean_01干净图 · 答「无」(单行紧凑 JSON)本次唯一有正文的干净图回复,判定正确;节制 1.0
{"misleading":false,"items":[],"fix_code":""}clean_02干净图 · 答「无」(带空格的单行 JSON)判定正确,节制 1.0(初跑失败、补跑补齐的样本)
{"misleading": false, "items": [], "fix_code": ""}mis_00误导图 · 点名「截断纵轴/非零基线」等 2 条手法召回 0.0 · 误报数 1
{"misleading":true,"items":[{"technique":"截断纵轴/非零基线用于柱状图(小字标注不足以抵消)","false_conclusion":"读者会把柱高比例误当真实用户量比例:按柱高估计会得出 W4 约为 W1 的 1.9–2.0 倍、W3 约为 1.5 倍、W2 约为 1.25 倍;但纵轴不从 0 开始,真实倍数必然更小,且起点数值未给出,读者无法校正。"},{"technique":"省略纵轴刻度、网格线与数据标签","false_conclusion":"读者无法读出 W1-W4 的具体万数、相邻周差值或百分比,只能凭红色柱高猜测;这会把视觉上的巨大落差当成实际绝对增长,或使人意识不到轴已被截断。"}],"fix_code":"import matplotlib.pyplot as plt\n\n# 图中可读出的只有:类别 W1-W4、指标名“周活跃用户”、单位“万”;具体数值和纵轴起点未标出。\n# 请将 None 替换为原始数据(单位:万)。不要从被截断的柱高反推数值。\nvalues = {'W1': None, 'W2': None, 'W3': None, 'W4': None}\nassert all(v is not None for v in values.values()), '请填入真实数值后再绘图'\n\nlabels = list(values.keys())\ny = [values[k] for k in labels]\n\nfig, ax = plt.subplots(figsize=(6, 4))\nbars = ax.bar(labels, y, color='#c0392b')\nax.set_ylim(0, max(y) * 1.15) # 柱状图必须使用零基线\nax.set_ylabel('周活跃用户(万)')\nax.set_title('周活跃用户(万)')\nax.grid(axis='y', alpha=0.3)\nax.bar_label(bars, fmt='%.1f')\n\n# 如需强调变化,用真实差值/百分比在标题或注释中说明,而不是截断柱高:\n# pct = [(y[i] / y[i-1] - 1) * 100 for i in range(1, len(y))]\nplt.tight_layout()\nplt.show()"}↑ 此条为模型输出的原始形态:单行紧凑 JSON,fix_code 内的换行是字面的 \n 转义序列(原样保留)。
mis_01误导图 · 读出红字「1149 万元起」,点名非零基线召回 0.0 · 误报数 1
{
  "misleading": true,
  "items": [
    {
      "technique": "非零基线/截断纵轴的柱状图",
      "wrong_conclusion": "读者会把柱高比例当成营收比例:图上 D 柱约为 A 柱的 1.6 倍、D 也明显高于 B/C,从而得出“D 营收约比 A 多六成、门店差距很大”的结论。但图中红字可读纵轴从 1149 万元起,柱高只编码“超过 1149 的部分”;真实营收比应是 (1149+d_D)/(1149+d_A),必然小于柱高比,且在差额相对 1149 不大时会接近 1。"
    },
    {
      "technique": "只标注截断起点,不提供纵轴刻度/终点和数据标签",
      "wrong_conclusion": "读者无法把“1149 起”转换成可量化校正,容易仍把 x 轴当 0,或无法判断 D 比 A 实际多多少万元/百分比。图中可读出的只有门店 A/B/C/D、单位万元和起点 1149;各店真实营收读不出。"
    }
  ],
  "fix_code": "import matplotlib.pyplot as plt\n\nstores = ['A', 'B', 'C', 'D']\nunit = '万元'\naxis_start_read_from_chart = 1149  # 图中红字可读;只用于偏差说明,不得作为营收柱的 y 轴下限\nrevenue = {'A': None, 'B': None, 'C': None, 'D': None}  # PLACEHOLDER: 图中读不出真实营收,请用原始数据替换;不要由柱高反推\nbar_height_px_audit_only = {'A': 130, 'B': 152, 'C': 141, 'D': 207}  # 仅记录图像像素,不是营收\n\nif any(revenue[s] is None for s in stores):\n    raise ValueError('真实营收在图中读不出;请填充 revenue 后再画。诚实图不能用像素柱高或 1149 起点反推营收。')\n\nvals = [revenue[s] for s in stores]\nfig, ax = plt.subplots(figsize=(7, 4))\nbars = ax.bar(stores, vals, color='#C44536')\nax.set_ylim(0, max(vals) * 1.15)\nax.set_ylabel('营收(' + unit + ')')\nax.set_title('各门店营收(' + unit + ')')\nax.bar_label(bars, fmt='%.0f')\nax.grid(axis='y', alpha=0.25)\nax.set_axisbelow(True)\nfig.text(0.01, 0.01, '诚实版本:营收柱 y 轴从 0 开始;1149 仅为原图截断起点。', ha='left')\nplt.tight_layout(rect=[0, 0.04, 1, 1])\nplt.show()\n\n# 如分析重点是相对 1149 的差额,应单独画偏差图,且不得把它叫作营收:\n# dev = [v - axis_start_read_from_chart for v in vals]\n# fig2, ax2 = plt.subplots(figsize=(7, 3))\n# b2 = ax2.bar(stores, dev, color='#4C78A8')\n# ax2.axhline(0, color='black', linewidth=0.8)\n# ax2.set_ylabel('营收 - 1149(' + unit + ')')\n# ax2.set_title('相对 1149 ' + unit + ' 的差额(非营收本身)')\n# ax2.bar_label(b2, fmt='%.0f')\n# plt.tight_layout()\n# plt.show()"
}mis_02误导图 · 读出红字「纵轴从84起」,点名非零基线召回 0.0 · 误报数 1
{"misleading": true, "items": [{"technique": "柱状图纵轴截断(非零基线,图中红字自承'纵轴从84起')", "wrong_conclusion": "柱形图用长度编码数值,纵轴从84而非0开始后,读者会按柱子高度直觉比较:春季与秋季看起来相近、冬季柱子约为春/秋的1.7倍,从而得出'冬季故障工单数比春/秋季多约七成、季度间波动很大'的错误结论;按柱高反推,若春≈98、冬≈108,则截断轴把(108-84)/(98-84)=24/14≈1.71的视觉差异放大,而真实差异108/98仅约+10%。图上小字标注并不能消除该误导,因为读者仍用柱长做判断。"}], "fix_code": "import matplotlib.pyplot as plt\n\nquarters = ['春', '夏', '秋', '冬']\n# 图中唯一可读的数值信息:原图纵轴从 84 起(红字);四个季度的真实工单数没有 y 轴刻度/数据标签,读不出。\n# 下列 counts 为按柱高相对比例反推的 PLACEHOLDER 估计(满足 春≈秋<夏<冬,且在基线 84 下 (v-84) 的比接近原图柱高比),发布前必须替换为真实工单数。\nORIGINAL_TRUNCATED_BASELINE = 84 # 原图可读:非零基线\ncounts = [98, 101, 98, 108] # PLACEHOLDER/估计:真实值图中不可读,勿直接用于结论\n\nfig, ax = plt.subplots(figsize=(6, 4))\nbars = ax.bar(quarters, counts, color='#C0392B')\nax.set_ylim(0, max(counts) * 1.18) # 诚实做法:柱状图纵轴必须从 0 开始\nax.set_title('季度故障工单数')\nax.set_ylabel('故障工单数(件)')\nfor b, v in zip(bars, counts):\n ax.text(b.get_x() + b.get_width() / 2, v, str(v), ha='center', va='bottom', fontsize=10)\n# 不画被截断的基线;如确需展示与目标阈值的关系,用水平参考线而非截断 y 轴。\nplt.tight_layout()\nplt.show()"}↑ 此条为模型输出的原始形态:单行紧凑 JSON,fix_code 内的换行是字面的 \n 转义序列(原样保留)。
mis_03误导图 · 读出红字「纵轴从40起」,点名非零基线召回 0.0 · 误报数 1
{"misleading":true,"items":[{"technique":"柱状图截断纵轴/非零基线(图上小字自称“纵轴从40起”)","wrong_conclusion":"读者会把柱高当成从零开始的完整长度,从而按视觉高度比读出错误倍数:Q4 看起来约为 Q1/Q3 的 2.2 倍、Q2 约为 Q1/Q3 的 1.4 倍;实际上基线被设为 40,柱高只代表“超过 40 的部分”,真实满意度倍数必须用原始数值相对零基线或直接用数值标注判断,不能按截断后的柱高比较。原图没有可读纵轴刻度,具体数值读不出,因此代码中使用 None 占位并强制先填真实值。"}],"fix_code":"import matplotlib.pyplot as plt\n\nlabels = ['Q1', 'Q2', 'Q3', 'Q4']\nvalues = [None, None, None, None] # 占位:原图只能读出 Q1-Q4;纵轴无刻度,真实满意度值读不出\n\nif any(v is None for v in values):\n raise ValueError('原图缺少可读纵轴刻度,无法从像素恢复真实数值;请把 values 替换为真实的 [Q1, Q2, Q3, Q4] 后再绘制。')\n\nfig, ax = plt.subplots(figsize=(6, 4))\nbars = ax.bar(labels, values, color='#C04A3B')\nax.set_ylim(0, max(values) * 1.15) # 诚实版本:柱状图必须从 0 开始\nax.set_ylabel('满意度评分')\nax.set_title('满意度评分(零基线)')\nax.spines['top'].set_visible(False)\nax.spines['right'].set_visible(False)\n\nfor bar, v in zip(bars, values):\n ax.annotate(f'{v:.1f}', xy=(bar.get_x() + bar.get_width() / 2, v), xytext=(0, 3), textcoords='offset points', ha='center', va='bottom')\n\nplt.tight_layout()\nplt.show()"}↑ 此条为模型输出的原始形态:单行紧凑 JSON,fix_code 内的换行是字面的 \n 转义序列(原样保留)。
① 节制轴上的差异真实可见,glm-5v-turbo 的过度指认最重。它把 3 张干净图全部判为「存在误导」,且每张都给出「Non-zero Baseline / 截断Y轴」类手法名(原文见上)——而那组图的真值是「无缺陷」;ox-alpha 为 2/3 判「误导」(其中 clean_00 已被计 0.0 加标、clean_02 未被扣分);kimi-k3 补跑补齐后的 3 张干净图全部答「无」,节制 1.0 现在建立在 7/7 有效回复上,可与另两家直接比较。
② 四张误导图上,三个模型的正文其实都点名了非零基线/截断纵轴类手法,但三方召回均为 0.0。这与本页上文异常②(mis_01 点名真值手法却记 0)是同一类现象:当前 aggregate 召回 0.0 对三家一体成立,度量的是打分管道的处理,区分不出三家的识别能力。
③ 对被图框裁切的红字的辨认,三方互不相同。同一张 mis_01:ox-alpha 读作「数据从140起」,kimi-k3 读作「纵轴从 1149 万元起」,glm-5v-turbo 读作「数据共14座(非零售类型)」;kimi-k3 在 mis_02 / mis_03 上还分别读出「84」「40」的起点。原图小字确实被裁切,三种读法孰对孰错本页无法裁定,仅并列呈现。
④ 补跑前后的对照(只陈述可核对的事实)。ox-alpha 初跑的 mis_02 / mis_03 与 kimi-k3 初跑的 clean_00 / clean_02 都没有正文(前者 finish_reason 记 stop、usage 为空,后者记 error、completion_tokens 全为 reasoning),初跑失败原因均无日志可查;补跑后四条均正常返回并参与计分。token 计数的方向差异仍在:kimi-k3 各条 reasoning_tokens 普遍大于 completion_tokens,而 ox-alpha 各条 reasoning 恒记 0、completion 远大于可见输出(见上方异常④)。