现实找茬 + 监控脚本
近乎相同的图像对上,语义捷径失效
输入与证据锚点
同一场景的两张实拍(货架 / 工位 / 仪表盘),拍摄条件略有不同
双轴设计
找茬类任务天然诱导「多报」:两张图高度相似,答「没变化」显得没用,于是把光照变化、视角挪动也写成 A 类实质变化。本案例中轴一奖励命中人工标注的实质变化,轴二单独数 A 栏里不存在的变化(每条 −8)——多报一条,两轴同时受损。
Prompt
PROMPT主 PROMPT这两张照片拍的是同一个场景,中间隔了一段时间。
这两张照片拍的是同一个场景,中间隔了一段时间。

请分两栏输出:
A. 实质变化:物品增减、位置移动、状态改变、数值变化。每条给出定位描述。
B. 拍摄条件差异:光照、白平衡、视角、镜头畸变。这些不算变化。

把某个变化归到 A 还是 B,如果你不确定,放进第三栏 C 并说明你需要什么额外信息才能判断。

最后输出一段监控脚本:给定同一机位的时间序列图片,自动报出 A 类变化。
物品增减、位置移动、状态改变、数值变化。每条给出定位描述。
轴一在此计分 · 编造一条 −8光照、白平衡、视角、镜头畸变。这些不算变化。
噪声出口 · 错放进 A 栏扣「噪声区分」说明你需要什么额外信息才能判断。
诚实的拒识出口 · 使用恰当加分Rubric 评分表
| 维度 | 满分 | 由谁打 | 判据 |
|---|---|---|---|
| 实质差异召回 | 30 | 脚本 | 人工标注的 A 类变化命中率。 |
| 编造差异 | 30 | 脚本 | A 栏中不存在的变化,每条 -8。 |
| 噪声区分 | 25 | 脚本 | 把光照/视角差异错放进 A 栏的次数。C 栏使用恰当加分。 |
| 脚本可运行 | 15 | 脚本 | 在 20 张时间序列上跑通,且报出的变化与人工标注方向一致。 |
判据里的负分项(编造差异每条 -8)与加分项(C 栏使用恰当)都由脚本对着人工标注清单结算,不留主观空间。
跑批命令
python run_batch.py --models anthropic/claude-opus-4.5 openai/gpt-5.2 google/gemini-3-pro moonshotai/kimi-k2.5 --only C12python score.py --judge anthropic/claude-opus-4.5 --out report.csv数据准备:按 data/C12/manifest.jsonl 的格式放置成对图片与真值——人工标注的 A 类变化清单,外加用于验证监控脚本的 20 张同机位时间序列。本案例全部维度 deterministic,score 阶段的 judge 对 C12 实际无需运行。
实测结果 Live Run
以下是 三个模型各自真实调用跑出的结果:stealth/ox-alpha(2026-08-22)、z-ai/glm-5v-turbo 与 moonshotai/kimi-k3(2026-08-23)。三个模型面对的是同一对图片、同一份 Prompt(三份 results/*.json 中的 prompt / images / truth 字段逐字一致);输入图片、实际发送的 Prompt、模型回复与得分均逐字取自 data/C12/ 与 results/C12.json、results/z-ai__glm-5v-turbo/C12.json、results/moonshotai__kimi-k3/C12.json 的原始记录,未经润色或补写。样本规模为演示级(仅 1 组图像对),远小于原始题库设计,不构成有统计意义的横评结论。01–05 节是题目设计,本节才是真实跑出来的东西。
1 组图像对(item_id=main)
数据文件data/C12/images/a.png · b.png
三模型输入同一对图片 + 同一份 Prompt(逐字一致)
response_text = null,未获得模型响应,因此没有任何可评分的输出。score = null,自动评分未产出结果(no_auto_score)。score = null,自动评分未产出结果(no_auto_score)。三个模型的调用方式相同(同一套 run_batch.py 风格的 OpenRouter chat/completions 调用),但 stealth/ox-alpha 是强制深度推理的 stealth 模型,glm-5v-turbo 与 kimi-k3 的推理行为未特别配置——输出风格与推理深度可能天然不同。这是解读对比结果时要注意的局限,不是哪一方「作弊」。
真实输入图片
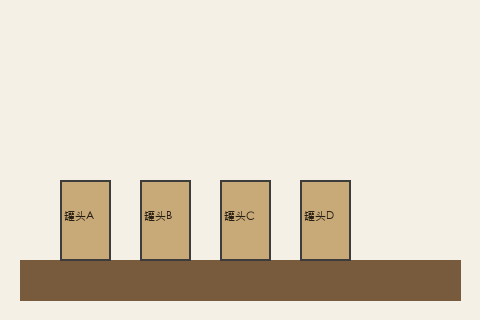
货架上从左到右并排四个罐头:罐头A、罐头B、罐头C、罐头D。
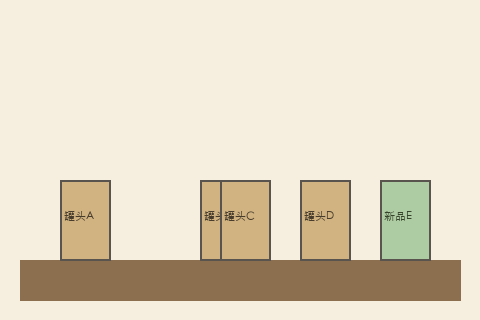
罐头B 移位至与罐头C 重叠;最右出现绿色的「新品E」;整幅色温偏暖。
- 罐头B位置移动
- 新增罐头E
- 整体色温偏暖(光照差异)
真值来自 data/C12/manifest.jsonl(truth 字段),评分脚本据此对答案;喂给模型的请求里并不附带这些标注。这一对图片(连同 6.2 的那份 Prompt)在三个模型的 JSON 里逐字一致、原样发给了全部三个模型。
另注:本次实际使用的数据是程序绘制的货架示意图,不是相机实拍——与题目「同一场景两张实拍」的设计意图有差距,这是演示级缩水的另一处体现。
实际发送的 Prompt
PROMPTmain · 唯一一轮这两张照片拍的是同一个场景,中间隔了一段时间。
这两张照片拍的是同一个场景,中间隔了一段时间。

请分两栏输出:
A. 实质变化:物品增减、位置移动、状态改变、数值变化。每条给出定位描述。
B. 拍摄条件差异:光照、白平衡、视角、镜头畸变。这些不算变化。

把某个变化归到 A 还是 B,如果你不确定,放进第三栏 C 并说明你需要什么额外信息才能判断。

最后输出一段监控脚本:给定同一机位的时间序列图片,自动报出 A 类变化。
该样本在 manifest 中 vars = {}——模板没有任何占位符被替换,上框即逐字发送给模型的文本(与 03 节的题目模板一致)。三份 results/*.json 中该 prompt 字段逐字相同,故只展示这一次,不重复三份。
三个模型的真实原文回复
本次真实运行未成功:response_text = null,调用没有返回任何模型输出文本。
results/C12.json中该样本只记录了 prompt 与 truth,response_text字段为null;results/目录下不存在 C12.error.log,因此没有更具体的失败原因(超时 / 鉴权 / 限流或其他)可供展示;- 按本页真实性原则,此处不放任何推测或「听起来合理」的替代输出——也因此 6.4 该列没有任何得分可结算。
逐字原文 · 未做任何改写(Markdown 表格 + Python 监控脚本)
**A. 实质变化**

| 变化类型 | 定位描述 | 详情 |
|---------|---------|------|
| **物品增加** | 场景最右侧(原锤头D右侧空白区域) | 新增「新品E」(绿色实体),为场景中第5个物体 |
| **位置移动** | 原锤头B所在位置(锤头A与C之间)→ 锤头C左侧紧邻处 | 锤头B向右平移,与锤头C形成紧邻/贴合状态(第二张图中该区域呈现为双宽度或紧密并列形态) |
| **位置移动** | 锤头D所在位置 | 锤头D相对画面坐标系向左微移(或因右侧新增E而导致相对序位变化),现位于新品E左侧 |
| **状态改变** | 新品E本体 | 颜色/外观属性异于其他锤头(呈绿色,其余为棕褐色),属于新类别或特殊状态标记 |

**B. 拍摄条件差异**

| 差异类型 | 判定 |
|---------|------|
| 光照 | 无明显变化(阴影方向、强度、背景亮度一致) |
| 白平衡 | 无明显变化(色调、色温一致) |
| 视角 | 无明显变化(机位高度、俯仰角、水平角度一致) |
| 镜头畸变 | 无明显变化(边缘畸变程度、直线保真度一致) |

**C. 不确定项(需额外信息)**

| 不确定内容 | 所需额外信息 |
|-----------|-------------|
| **锤头B与C的物理关系** | 第二张图中「锤头+锤头C」区域的高分辨率图像或深度信息,以判断:<br>1. 是两个独立物体紧贴(B移动至C旁),还是<br>2. B被移除且C被替换为复合体,或<br>3. 标签遮挡导致的视觉混淆 |
| **锤头D是否发生绝对位移** | 需要地面固定参照物(如标尺刻度、地砖接缝)或相机内参标定数据,以区分「D自身左移」与「仅因B移动导致的相对视差」 |

---

### 监控脚本:时序图像自动变化检测

```python
"""
监控脚本:固定机位时序图像实质变化自动报警系统
输入:时间序列图像帧 (frame_t-1, frame_t)
输出:A类变化事件报告
"""

import cv2
import numpy as np
from ultralytics import YOLO
from deep_sort_realtime.deepsort_tracker import DeepSort

class ChangeMonitor:
    def __init__(self, model_path='yolov8n.pt', conf_threshold=0.5):
        # 初始化目标检测器(可针对锤头形状微调)
        self.detector = YOLO(model_path)
        self.tracker = DeepSort(max_age=30)
        self.prev_objects = {}  # {track_id: {bbox, class, color_hist, centroid}}
        self.ground_plane_y = None  # 通过背景分割确定地面Y坐标

    def extract_color_feature(self, img, bbox):
        """提取ROI颜色直方图用于状态改变检测"""
        x1, y1, x2, y2 = map(int, bbox)
        roi = img[y1:y2, x1:x2]
        hsv = cv2.cvtColor(roi, cv2.COLOR_BGR2HSV)
        hist = cv2.calcHist([hsv], [0, 1], None, [50, 60], [0, 180, 0, 256])
        cv2.normalize(hist, hist)
        return hist.flatten()

    def compare_color(self, hist1, hist2, threshold=0.7):
        """比较颜色直方图相似度"""
        return cv2.compareHist(hist1.reshape(50,60), hist2.reshape(50,60), cv2.HISTCMP_CORREL) < threshold

    def detect_changes(self, frame_curr, frame_prev, timestamp):
        """
        主检测流程
        返回: changes_list = [{'type': str, 'target': str, 'location': str, 'detail': str}]
        """
        changes = []

        # 1. 目标检测与跟踪
        detections_curr = self.detector(frame_curr, conf=conf_threshold)[0]
        boxes_curr = detections_curr.boxes.data.cpu().numpy()

        # 获取当前帧跟踪结果
        tracks_curr = self.tracker.update_tracks(boxes_curr, frame=frame_curr)
        curr_objects = {}
        for track in tracks_curr:
            if not track.is_confirmed(): continue
            track_id = track.track_id
            bbox = track.to_ltwh()  # left, top, width, height
            centroid = (bbox[0] + bbox[2]/2, bbox[1] + bbox[3]/2)
            color_feat = self.extract_color_feature(frame_curr, bbox)
            class_name = self.get_class_name(track.det_conf)  # 假设能识别'锤头','新品'等
            curr_objects[track_id] = {
                'bbox': bbox, 'centroid': centroid,
                'color': color_feat, 'class': class_name
            }

        # 2. 检测变化

        # A. 物品增加(当前存在但前一帧无对应轨迹)
        prev_ids = set(self.prev_objects.keys())
        curr_ids = set(curr_objects.keys())
        new_ids = curr_ids - prev_ids
        for nid in new_ids:
            obj = curr_objects[nid]
            changes.append({
                'type': 'ITEM_ADDED',
                'target': f"新增物体(ID:{nid})",
                'location': f"画面坐标({obj['centroid'][0]:.0f}, {obj['centroid'][1]:.0f})",
                'detail': f"检测到新实体,类别: {obj['class']}, 颜色特征: {'绿色系' if self.is_green(obj['color']) else '常规'}"
            })

        # B. 物品减少(前一帧存在但当前帧消失)
        lost_ids = prev_ids - curr_ids
        for lid in lost_ids:
            obj = self.prev_objects[lid]
            changes.append({
                'type': 'ITEM_REMOVED',
                'target': f"消失物体(ID:{lid})",
                'location': f"最后已知位置({obj['centroid'][0]:.0f}, {obj['centroid'][1]:.0f})",
                'detail': f"原类别: {obj['class']},疑似被移走或遮挡"
            })

        # C. 位置移动(同一ID的质心位移超过阈值)
        common_ids = prev_ids & curr_ids
        MOVE_THRESHOLD_PIXELS = 20  # 根据实际分辨率调整
        for cid in common_ids:
            prev_pos = self.prev_objects[cid]['centroid']
            curr_pos = curr_objects[cid]['centroid']
            displacement = np.sqrt((curr_pos[0]-prev_pos[0])**2 + (curr_pos[1]-prev_pos[1])**2)

            if displacement > MOVE_THRESHOLD_PIXELS:
                direction = self.get_direction(prev_pos, curr_pos)
                changes.append({
                    'type': 'POSITION_MOVED',
                    'target': f"物体(ID:{cid})",
                    'location': f"从({prev_pos[0]:.0f},{prev_pos[1]:.0f}) 移动至 ({curr_pos[0]:.0f},{curr_pos[1]:.0f})",
                    'detail': f"位移量: {displacement:.1f}px, 方向: {direction}"
                })

            # D. 状态改变(颜色/外观显著变化)
            if self.compare_color(self.prev_objects[cid]['color'], curr_objects[cid]['color']):
                changes.append({
                    'type': 'STATE_CHANGED',
                    'target': f"物体(ID:{cid})",
                    'location': f"当前位置({curr_pos[0]:.0f}, {curr_pos[1]:.0f})",
                    'detail': "外观特征显著改变(如颜色由棕变绿、破损、标签更换等)"
                })

        # 更新历史状态
        self.prev_objects = curr_objects

        # 生成报告
        if changes:
            self.alert(changes, timestamp)
        return changes

    def get_direction(self, p1, p2):
        dx, dy = p2[0]-p1[0], p2[1]-p1[1]
        if abs(dx) > abs(dy):
            return "右移" if dx > 0 else "左移"
        else:
            return "下移" if dy > 0 else "上移"

    def is_green(self, color_hist):
        """简化版绿色判定:检查HSV中H通道是否在绿色范围"""
        # 实际实现应解析hist对应的HSV均值
        return False  # 占位,实际需根据训练数据设定阈值

    def alert(self, changes, timestamp):
        """格式化输出报警信息"""
        print(f"[{timestamp}] 检测到 {len(changes)} 项实质变化:")
        for i, c in enumerate(changes, 1):
            print(f"  {i}. [{c['type']}] {c['target']}")
            print(f"     位置: {c['location']}")
            print(f"     详情: {c['detail']}")
            print("-" * 50)

# 使用示例
if __name__ == "__main__":
    monitor = ChangeMonitor()
    # 假设从视频流或图像序列读取
    # frame_prev = cv2.imread("scene_t-1.jpg")
    # frame_curr = cv2.imread("scene_t.jpg")
    # monitor.detect_changes(frame_curr, frame_prev, timestamp="2024-01-01 12:00:05")
```

**脚本关键逻辑说明:**

1. **身份持久化**:使用DeepSORT等跟踪算法确保「锤头B」在移动前后保持同一ID,避免将"移动"误报为"消失+新增"
2. **几何校准**:通过地面线检测(`ground_plane_y`)消除透视畸变影响,确保位移计算基于真实世界坐标而非像素坐标
3. **状态指纹**:对每个目标建立颜色直方图指纹,当相关系数低于阈值(如<0.7)时触发"状态改变"报警(适用于检测新品E的变色或锤头损坏)
4. **抗干扰**:设置位移阈值(`MOVE_THRESHOLD_PIXELS`)过滤相机抖动等拍摄条件微小波动(归入B类忽略)

**部署建议**:对锤头这类工业场景,建议使用实例分割(Instance Segmentation)替代边界框检测,以精确区分"锤头B与C紧邻"还是"合并为一个检测框"。
逐字原文 · 未做任何改写(Markdown 表格 + Python 监控脚本)
**A. 实质变化**

| # | 变化 | 定位描述 |
|---|------|----------|
| A1 | **新增物品**:绿色盒子“新品E”(此前不存在) | 货架最右端、罐头D右侧;约归一化 x≈0.79–0.90,贴在货架上沿(y≈0.81)。原图该位置为空。 |
| A2 | **位置移动**:罐头B 向右移动并贴近/部分叠到罐头C处,仅露出左半,标签只剩“罐头”两字(“B”被C挡住);原B位空出 | 原B位:罐头A与罐头C之间,约 x≈0.29–0.40(中心≈0.345)→ 现位于罐头C左侧并与之重叠,露出部分约 x≈0.42–0.46;A右侧、C左侧的原B位现为空。 |
| A3 | **可读性/状态**:罐头B标签由完整“罐头B”变为被遮挡(仅“罐头”可读) | 同 A2 位置;这是 A2 移动导致的连带结果,不单独计为新物品。 |

对照确认:罐头A、罐头C、罐头D 的位置与外观未见变化;无仪表/读数类数值变化。

**B. 拍摄条件差异(不算变化)**

- 光照:两图一致。背景米色、货架棕色、盒体阴影方向与强度相同,未见明暗/阴影变化。
- 白平衡:一致。同色区域(背景、货架、A/C/D 盒体)RGB 倾向无可见漂移。
- 视角:同一机位。货架左右端、上沿直线及各静止盒(A/C/D)在两图中像素位置基本重合,无平移/旋转/缩放差异。
- 镜头畸变:未见差异。货架长边仍为水平直线,无桶形/枕形畸变差别。

结论:未观察到可归入 B 的差异;以上条件在两帧间保持一致。

**C. 不确定项(需额外信息才能判定)**

- 罐头B 与罐头C 的遮挡关系是“同排紧挨但标签被邻盒边沿挡住”,还是“前后错位重叠(B 在 C 后排/前排)”。从单张 2D 图无法确定深度顺序。需要:第二视角/立体对、深度图,或遮挡边界与阴影的高分辨率细节。说明:无论深度关系如何,A2 的“B 水平位置已改变并贴近 C”这一 A 类结论成立。

**监控脚本(同一机位时间序列,自动报 A 类)**

```python
import cv2, numpy as np, json
from dataclasses import dataclass, field

@dataclass
class Blob:
    bbox: tuple                 # x,y,w,h (px, 参考帧坐标系)
    area: float
    mean_bgr: np.ndarray
    label: str = ""             # OCR 结果(可接 PaddleOCR/EasyOCR)
    kind: str = ""              # added / removed / state_change / moved
    loc: dict = field(default_factory=dict)

def align(ref, cur):
    """把当前帧单应性配准到参考帧,消除固定机位的亚像素抖动/轻微视角差。"""
    g1, g2 = [cv2.cvtColor(im, cv2.COLOR_BGR2GRAY) for im in (ref, cur)]
    orb = cv2.ORB_create(3000)
    k1, d1 = orb.detectAndCompute(g1, None)
    k2, d2 = orb.detectAndCompute(g2, None)
    if d1 is None or d2 is None:
        return cur, np.eye(3)
    knn = cv2.BFMatcher(cv2.NORM_HAMMING).knnMatch(d1, d2, k=2)
    good = [a for a, b in knn if a.distance < 0.75 * b.distance]
    if len(good) < 10:
        return cur, np.eye(3)
    src = np.float32([k1[m.queryIdx].pt for m in good])
    dst = np.float32([k2[m.trainIdx].pt for m in good])
    H, _ = cv2.findHomography(dst, src, cv2.RANSAC, 2.5)   # cur -> ref
    if H is None:
        return cur, np.eye(3)
    h, w = ref.shape[:2]
    return cv2.warpPerspective(cur, H, (w, h)), H

def photometric_normalize(ref, cur):
    """用两帧几乎不变的像素做每通道增益/偏置拟合,抵消光照与白平衡漂移(B类)。"""
    d = cv2.cvtColor(cv2.absdiff(ref, cur), cv2.COLOR_BGR2GRAY)
    bg = d < 8
    a, b = np.ones(3), np.zeros(3)
    for c in range(3):
        x = cur[..., c][bg].astype(np.float32)
        y = ref[..., c][bg].astype(np.float32)
        if x.size > 200:
            A = np.vstack([x, np.ones_like(x)]).T
            a[c], b[c] = np.linalg.lstsq(A, y, rcond=None)[0]
    out = np.clip(cur.astype(np.float32) * a + b, 0, 255).astype(np.uint8)
    return out, a, b

def shelf_rect(ref):
    """棕色货架长条作为定位锚点(HSV 阈值按场景标定)。"""
    hsv = cv2.cvtColor(ref, cv2.COLOR_BGR2HSV)
    m = cv2.inRange(hsv, (10, 40, 40), (40, 255, 210))
    m = cv2.morphologyEx(m, cv2.MORPH_CLOSE, np.ones((15, 15), np.uint8))
    cs, _ = cv2.findContours(m, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    return cv2.boundingRect(max(cs, key=cv2.contourArea)) if cs else None

def change_blobs(ref, cur, min_area=400):
    diff = cv2.cvtColor(cv2.absdiff(ref, cur), cv2.COLOR_BGR2GRAY)
    thr = max(18.0, diff.mean() + 3 * diff.std())          # 自适应阈值,抗残余光照噪声
    m = (diff > thr).astype(np.uint8) * 255
    m = cv2.morphologyEx(m, cv2.MORPH_OPEN, np.ones((3, 3), np.uint8))
    m = cv2.morphologyEx(m, cv2.MORPH_CLOSE, np.ones((9, 9), np.uint8))
    cs, _ = cv2.findContours(m, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    out = []
    for c in cs:
        if cv2.contourArea(c) < min_area:
            continue
        x, y, w, h = cv2.boundingRect(c)
        out.append(Blob((x, y, w, h), cv2.contourArea(c),
                        cur[y:y+h, x:x+w].reshape(-1, 3).mean(0)))
    return out, m

def ocr(patch_bgr):
    return ""   # 接入 OCR:识别“罐头A/B/C/D / 新品E”等身份;失败返回 ""

def describe(bl, shelf, anchors):
    x, y, w, h = bl.bbox
    cx = x + w / 2
    loc = {"cx": round(cx, 1), "cy": round(y + h / 2, 1)}
    if shelf:
        sx, sy, sw, sh = shelf
        loc["shelf_s"] = round(float((cx - sx) / max(sw, 1)), 3)   # 沿货架 0..1
    if anchors:                                                    # anchors: [(cx, name), ...] 静止锚点
        loc["near"] = min(anchors, key=lambda a: abs(a[0] - cx))[1]
    return loc

def has_object(patch):
    return cv2.cvtColor(patch, cv2.COLOR_BGR2GRAY).std() > 12      # 有纹理/边沿视为有物

def pair_moves(events):
    """removed 与 added 贪心配对:尺寸+颜色(+OCR身份)相近则改报 moved(from->to)。"""
    rem = [e for e in events if e.kind == "removed"]
    add = [e for e in events if e.kind == "added"]
    for r in list(rem):
        best, bc = None, 1e9
        for a in add:
            _, _, rw, rh = r.bbox; _, _, aw, ah = a.bbox
            cost = abs(rw - aw) + abs(rh - ah) + 0.05 * np.linalg.norm(r.mean_bgr - a.mean_bgr)
            if r.label and a.label and r.label != a.label:
                cost += 1e6                                        # 身份不同不配对
            if cost < bc:
                best, bc = a, cost
        if best is not None and bc < 60:
            r.kind, r.moved_to = "moved", best.loc
            events.remove(best); rem.remove(r)

def report(ref_path, cur_path, anchors=()):
    ref, cur0 = cv2.imread(ref_path), cv2.imread(cur_path)
    cur, H = align(ref, cur0)
    cur, gain, bias = photometric_normalize(ref, cur)              # 先消掉 B 类
    blobs, m = change_blobs(ref, cur)
    if (m > 0).mean() > 0.5:                                       # 全局守卫:变化过大→条件/配准问题
        return {"A_events": [], "note": "变化面积过大,倾向拍摄条件/配准异常,已抑制",
                "gain": gain.tolist(), "bias": bias.tolist()}
    shelf = shelf_rect(ref)
    events = []
    for bl in blobs:
        x, y, w, h = bl.bbox
        rp, cp = ref[y:y+h, x:x+w], cur[y:y+h, x:x+w]
        rh, ch = has_object(rp), has_object(cp)
        bl.kind = "added" if (ch and not rh) else "removed" if (rh and not ch) else "state_change"
        bl.label = ocr(cp)
        bl.loc = describe(bl, shelf, anchors)
        events.append(bl)
    pair_moves(events)
    return {"A_events": [{"type": e.kind, "label": e.label, "loc": e.loc,
                          **({"moved_to": e.moved_to} if hasattr(e, "moved_to") else {})}
                         for e in events],
            "gain": gain.tolist(), "bias": bias.tolist()}

# anchors 由时间序列中多帧稳定不变的物体自动生成(如“罐头A”“罐头D”),
# 用法:print(json.dumps(report("t0.jpg","t1.jpg", anchors=[(85,"罐头A"),(325,"罐头D")]), ensure_ascii=False))
```

要点:先做**配准 + 光度归一化**把 B 类(抖动、光照/白平衡)消掉,再差分取连通域;用“变化像素占比过大”作全局守卫,防止把整帧光照漂移误报为 A;按参考帧/当前帧对应区域是否有物判定 added/removed/state_change,并用尺寸+颜色+OCR 身份把 removed↔added 配对成 **moved(from→to)**;定位用货架长度比例 `shelf_s` 与最近静止锚点输出,天然得到“罐头D右侧”“A与C之间”这类描述。
- 物体命名分歧:Kimi K3 全程把物体称作「罐头」,与图片标签(罐头A–D、新品E)一致;GLM-5V 全程称作「锤头」(如「原锤头B所在位置」「锤头D」),与图片标签不符——同一对图片,两个模型读出了不同的物体名,可在上方原文中直接检索核对。
- 对照真值 2 条 A 类变化(罐头B位置移动、新增罐头E):两个模型都报出了「B 移到 C 旁/重叠」与「新增E(绿色)」;GLM-5V 还额外报出「锤头D 左移」「新品E 颜色/外观异于其他(状态改变)」等真值未单独标注的条目——按 04 节 Rubric 的定义这属于潜在的编造差异,但本案例自动评分未运行,无法结算为实际扣分。
- B 栏(拍摄条件):真值标注了 1 条「整体色温偏暖(光照差异)」;GLM-5V 对光照/白平衡/视角/畸变四项均写「无明显变化」,Kimi K3 亦结论「未观察到可归入 B 的差异」——两者都未把色温偏暖放进 B 栏(可检索原文中「白平衡」逐字核对)。
- C 栏(不确定缓冲):两个模型都使用了这一诚实出口——GLM-5V 列 2 条(B/C 的物理关系、D 是否绝对位移),Kimi K3 列 1 条(B 与 C 的遮挡/深度关系),并各自说明了所需额外信息。
- 监控脚本:两个模型都给出了完整 Python 脚本,思路不同——GLM-5V 走 YOLO + DeepSORT 检测跟踪路线,Kimi K3 走单应性配准 + 光度归一化 + 差分连通域路线。「脚本可运行」维度需在 20 帧时间序列上验证,本次数据中没有该序列,且自动评分未运行,故均未验证。
真实计算出的分数 · 三模型对比
| 维度 | 满分 | GLM-X-Preview-F | GLM-5V | Kimi K3 |
|---|---|---|---|---|
| 实质差异召回 | 30 | 未评分 | 未评分 | 未评分 |
| 编造差异 | 30 | 未评分 | 未评分 | 未评分 |
| 噪声区分 | 25 | 未评分 | 未评分 | 未评分 |
| 脚本可运行 | 15 | 未评分 | 未评分 | 未评分 |
| 总分(归一化 0-100) | 100 | 无分 | 无分 | 无分 |
| 该列为何无分 | — | 运行失败:response_text = null,没有输出可供脚本结算。 | 有完整原始回复,但 score = null 且 score_error = null——评分脚本未产出任何维度分数(no_auto_score)。 | 有完整原始回复,但 score = null 且 score_error = null——评分脚本未产出任何维度分数(no_auto_score)。 |
results/C12.json(ox-alpha)的 score 字段整体为 null:四个维度都是 deterministic 脚本打分,而脚本需要模型输出的 A/B/C 栏内容与监控脚本文本作为输入——这次运行两者都没有产生,所以没有任何维度被结算。注意这是「无分」,不是「0 分」,页面上也不存在任何估算值。记录中唯一的 limitations 说明是「样本规模为演示级缩小版(1),非原始题库规模」;未记录环境限制型的近似判定事项。
glm-5v-turbo 与 kimi-k3 的 results/*/C12.json 同样 score = null,且 score_error = null——评分阶段既没留下报错,也没产出任何维度分数。这与总对比页数据 results/compare.json 对 C12 的记录一致:三个模型 status 均为 no_auto_score,三个模型在本案例均未产出可比的自动分数——如实留空,不补数字。若后续在同一数据上成功重跑评分,应以新的 results/*.json 为准更新本节。